文献情報
- タイトル:Quantum Circuit Learning
- 著者:K. Mitarai, M. Negoro, M. Kitagawa, and K. Fujii
- DOI:https://doi.org/10.1103/PhysRevA.98.032309
- 出版年:2018
概要
量子回路学習とはパラメータを持った量子回路全体を学習モデルとして扱い、パラメータの反復的な更新により与えられたタスクを学習する枠組みです。ハードウェアにおける長期的な課題として、量子ビットは周囲の環境との相互作用やゲート操作の誤差によって、量子状態を正確に保持できる時間が限られていることが挙げられます。そのため、実行時間が長く、ゲート数の多い深い量子回路を高い精度で実行することは困難です。量子回路学習は比較的浅い量子回路で実装できるため、このような制約のある現在の量子ハードウェアにも適した枠組みです。
本論文では量子回路学習によって非線形関数の近似、分類問題、量子多体系ダイナミクスの近似の数値シミュレーションを行い、結果としてそれら全てに対して有効に機能することがわかりました。
背景
量子系
量子ビット
量子ビットとは、測定に対し状態によって確率的に$0$か$1$を返すビットのことを指します。
$0$の確率を$|\alpha|^2$、$1$の確率を$|\beta|^2$として量子ビットの状態$\ket{\psi}$は以下で表されます。
$$\ket{\psi}=\alpha\ket{0}+\beta\ket{1}=\begin{pmatrix}\alpha\\\beta\end{pmatrix}\tag{1}$$
ここで、$\alpha、\beta$はどの程度の重みで$0$状態と$1$状態が重ね合わさっているかを表す複素確率振幅です。$\alpha、\beta$が複素数である理由は、量子の世界において$0$状態と$1$状態のような離散的な量も波の性質を持ち互いに干渉すると考えるためです。
また、$\ket{0}$と$\ket{1}$は以下の列ベクトルを表します。すると、状態$\ket{\psi}$は$2$個の基底ベクトル$\ket{0}$、$\ket{1}$で以下のように表せます。
$$\ket{0}=\begin{pmatrix}1\\0\end{pmatrix}, \ket{1}=\begin{pmatrix}0\\1\end{pmatrix}\tag{2}$$
このとき、$|\alpha|^2$、$|\beta|^2$は確率であり、その総和は$1$なので、$|\alpha|^2+|\beta|^2=1$の条件が課されます。
多量子ビット系
量子ビットが複数存在する場合について考えます。
古典ビットが$N$個あるとき、その状態は$N$個の$0,1$の組み合わせにより$2^N$個のパターンが存在します。
量子の世界では$2^N$個のパターン全ての重ね合わせ状態が許されるため、量子ビットが$N$個あるとき、その系の状態$\ket{\psi}$は$2^N$個の複素数と$2^N$個の基底ベクトルで表されます。
例として$N=2$のときについて考えます。
$$\ket{\psi}=C_{00}\ket{00}+C_{01}\ket{01}+C_{10}\ket{10}+C_{11}\ket{11}=\begin{pmatrix}C_{00}\\C_{01}\\C_{10}\\C_{11}\end{pmatrix}s.t.\sum_{i_1,i_2}|C_{i_1i_2}|^2=1\tag{3}$$
ここで$|C_{00}|^2$は$1$ビット目が$0$かつ$2$ビット目が$0$の確率を表します。
また、$\ket{00}$はテンソル積$\ket{0}\otimes\ket{0}$の簡略表現として用いています。(テンソル積についてはAppendixに記載しました)
量子操作
量子ゲート
古典ビットに対するNOT、ANDなどのゲートのように、量子ゲートは量子ビットに対する演算に相当します。
状態$\ket{\psi}$に量子ゲートを適用することは、 $\ket{\psi}$に ユニタリ行列 共役転置行列$U^\dagger$が自身の逆行列$U^{-1}$になる行列$U$ $\left( \begin{pmatrix} a & b \\ c & d \\ \end{pmatrix}^\dagger = \begin{pmatrix} a^* & b^* \\ c^* & d^* \\ \end{pmatrix} \right)$ $U$による線形変換を行うことに対応します。
状態$\ket{\psi}=\begin{pmatrix}\alpha\\\beta\end{pmatrix}$に作用する量子ゲートの例として$X=\begin{pmatrix}0 & 1\\1 & 0\end{pmatrix}$を考えます。
$$X\ket{\psi}=\begin{pmatrix}0 & 1\\1 & 0\end{pmatrix}\begin{pmatrix}\alpha\\\beta\end{pmatrix}=\begin{pmatrix}\beta\\\alpha\end{pmatrix}\tag{4}$$
このように$0$状態と$1$状態の確率振幅が反転するため、$X$ゲートは古典ビットにおけるNOTゲートのようなゲートと考えることができます。
ゲート適用後の状態$\ket{\psi’}=\begin{pmatrix}\alpha’\\\beta’\end{pmatrix}$も適用前の状態と同様に$|\alpha’|^2$、$|\beta’|^2$は確率であるため、${|\alpha|}^2+{|\beta|}^2={|\alpha\prime|}^2+{|\beta\prime|}^2=1$を満たしている必要があります。つまり、量子ゲートは元のベクトルのノルム$1$を維持する線形変換である必要があります。
ユニタリ行列$U$は$U^\dagger U=I$を満たします。そのため、状態$\ket{\psi}$に作用させても、
$$
\|U\ket{\psi}\|^2
=(U\ket{\psi})^\dagger U\ket{\psi}=\bra{\psi}U^\dagger U\ket{\psi}
=\left\langle\psi|\psi\right\rangle=\|\ket{\psi}\|^2\tag{5}
$$
となり、ノルムを保存します。
多量子ビット系に作用するゲート
$N$量子ビット系に作用するゲートは$2^N\times2^N$ のユニタリ行列で表されます。
$2$量子ビット系の状態$\ket{\psi}=\begin{pmatrix}C_{00}\\C_{01}\\C_{10}\\C_{11}\end{pmatrix}$に作用する量子ゲートの例として$CNOT=\left(\begin{matrix}\begin{matrix}1&0\\0&1\\\end{matrix}&\begin{matrix}0&0\\0&0\\\end{matrix}\\\begin{matrix}0&0\\0&0\\\end{matrix}&\begin{matrix}0&1\\1&0\\\end{matrix}\\\end{matrix}\right)$を考えます。
$$CNOT\ket{\psi}=\left(\begin{matrix}\begin{matrix}1&0\\0&1\\\end{matrix}&\begin{matrix}0&0\\0&0\\\end{matrix}\\\begin{matrix}0&0\\0&0\\\end{matrix}&\begin{matrix}0&1\\1&0\\\end{matrix}\\\end{matrix}\right)\begin{pmatrix}C_{00}\\C_{01}\\C_{10}\\C_{11}\end{pmatrix}=\begin{pmatrix}C_{00}\\C_{01}\\C_{11}\\C_{10}\end{pmatrix}\tag{6}$$
このようにゲートを適用すると、$C_{10}$と$C_{11}$が反転したことがわかります。
$1$ビット目と$2$ビット目に分けて考えると、$1$ビット目が$0$の時何もせず、$1$ビット目が$1$の時$2$ビット目を反転するような作用であるとも捉えることができ、ビット間に相関が生まれていることがわかります。
このようにビット間の相関を生み出すゲートによりエンタングル状態を作ることができます。
エンタングル状態
各量子ビットの状態が独立でない状態をエンタングル状態といいます。
まず、各量子ビットが独立な状態$\ket{\psi}$を考えます。$2$量子ビット系では、各ビットの状態 $\ket{\psi_1}=\left(\begin{matrix}\alpha_1\\\beta_1\\\end{matrix}\right)$、$\ket{\psi_2}=\left(\begin{matrix}\alpha_2\\\beta_2\\\end{matrix}\right)$を用いてテンソル積で表せます。
$$\ket{\psi}=\ket{\psi_1}\bigotimes\ket{\psi_2}=\begin{pmatrix}\alpha_1\alpha_2\\\alpha_1\beta_2\\\beta_1\alpha_2\\\beta_1\beta_2\end{pmatrix}\tag{7}$$
これが各ビットが独立な状態です。
この状態に対して、$CNOT$ゲートのようなビット間の相関を生み出すゲートを適用することでエンタングル状態を作ることができます。
例として、$\ket{\psi_1}=\frac{1}{\sqrt{2}}\left(\begin{matrix}1\\1\\\end{matrix}\right)$、$\ket{\psi_2}=\left(\begin{matrix}1\\0\\\end{matrix}\right)$とします。
$$\ket{\psi}=\ket{\psi_1}\bigotimes\ket{\psi_2}=\frac{1}{\sqrt{2}}\left(\begin{matrix}1\\1\\\end{matrix}\right)\bigotimes\left(\begin{matrix}1\\0\\\end{matrix}\right)=\frac{1}{\sqrt{2}}\begin{pmatrix}1\\0\\1\\0\end{pmatrix}\tag{8}$$
これはテンソル積を用いて表現できているので、各ビットは独立です。ここに前述した$CNOT$を適用すると、
$$CNOT\ket{\psi}= \frac{1}{\sqrt{2}}\begin{pmatrix}1\\0\\0\\1\end{pmatrix}\tag{9}$$
となり、エンタングル状態となります。この状態が独立でないことを確認します。もしこの状態が独立であることを仮定すると、以下のように表現できることになります。
$$\frac{1}{\sqrt{2}}\begin{pmatrix}1\\0\\0\\1\end{pmatrix} = \begin{pmatrix}\alpha_1\\\beta_1\end{pmatrix}\otimes\begin{pmatrix}\alpha_2\\\beta_2\end{pmatrix} = \begin{pmatrix}\alpha_1\alpha_2\\\alpha_1\beta_2\\\beta_1\alpha_2\\\beta_1\beta_2\end{pmatrix}\tag{10}$$
しかしこの連立方程式を解こうとすると、$\alpha_1\beta_2=0$ かつ $\beta_1\alpha_2=0$ でありながら $\alpha_1\alpha_2\neq0$ かつ $\beta_1\beta_2\neq0$ を満たす必要があり、矛盾が生じます。
よって背理法により仮定が間違っていたことがわかるので、この状態はいかなる$1$量子ビット状態のテンソル積でも表せず、エンタングル状態であることがわかります。
このように、独立な状態では各ビットの状態を表す変数の積で表現されるのに対して、独立でないエンタングル状態では各次元に対して$1$つの変数を用いて表す必要があります。
量子ビット数 $N$ が増えるほどこの差は顕著になり、独立な状態の変数数 $2\times N$ に対して一般の状態の変数数は $2^N$ と指数的に増加します。つまりエンタングル状態を活用することで、はじめて $2^N$ 次元の状態空間が持つ豊かな表現力を全て使うことができます。
例)$3$量子ビット系の独立な状態$\ket{\psi}$、独立でない状態$\ket{\psi’}$
$$\ket{\psi}=\ket{\psi_1}\bigotimes\ket{\psi_2}\bigotimes\ket{\psi_3}=\left(\begin{matrix}\begin{matrix}\begin{matrix}\alpha_1\alpha_2\alpha_3\\\alpha_1\alpha_2\beta_3\\\end{matrix}\\\begin{matrix}\alpha_1\beta_2\alpha_3\\\alpha_1\beta_2\beta_3\\\end{matrix}\\\end{matrix}\\\begin{matrix}\begin{matrix}\beta_1\alpha_2\alpha_3\\\beta_1\alpha_2\beta_3\\\end{matrix}\\\begin{matrix}\beta_1\beta_2\alpha_3\\\beta_1\beta_2\beta_3\\\end{matrix}\\\end{matrix}\\\end{matrix}\right),\hspace{5pt}\ket{\psi’}=\left(\begin{matrix}C_{000}\\C_{001}\\C_{010}\\C_{011}\\C_{100}\\C_{101}\\C_{110}\\C_{111}\end{matrix}\right)\tag{11}$$
独立な状態では、テンソル積による因数分解ができると捉えることもできます。
量子回路
量子回路とは、量子ビットに対して適用する量子ゲートの種類や順序、測定の位置を表した設計図です。
量子回路図の例を図1に示します。
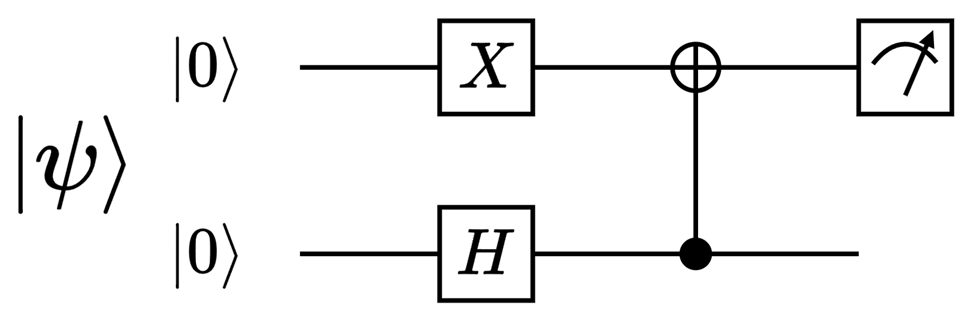
横線がそれぞれ$1$つの量子ビットを表し、時間は左から右へ進みます。横線上の四角形は、その量子ビットに作用する量子ゲートを表します。
縦線で結ばれた黒丸と⊕は$CNOT$ゲートを表し、黒丸が操作を制御する量子ビット、⊕が操作の対象となり反転しうる量子ビットを表します。また、メーター状の記号は量子ビットの測定を表します。
図1中の$X$ゲート、$H$ゲート、$CNOT$ゲートは、それぞれ以下の行列で表されます。
$$X=\left(\begin{matrix}0&1\\1&0\end{matrix}\right),\qquad H=\frac{1}{\sqrt{2}}\left(\begin{matrix}1&1\\1&-1\end{matrix}\right)\tag{12}$$
$$CNOT=\left(\begin{matrix}\begin{matrix}1&0\\0&1\\\end{matrix}&\begin{matrix}0&0\\0&0\\\end{matrix}\\\begin{matrix}0&0\\0&0\\\end{matrix}&\begin{matrix}0&1\\1&0\\\end{matrix}\\\end{matrix}\right)\tag{13}$$
状態の表現
ブロッホ球
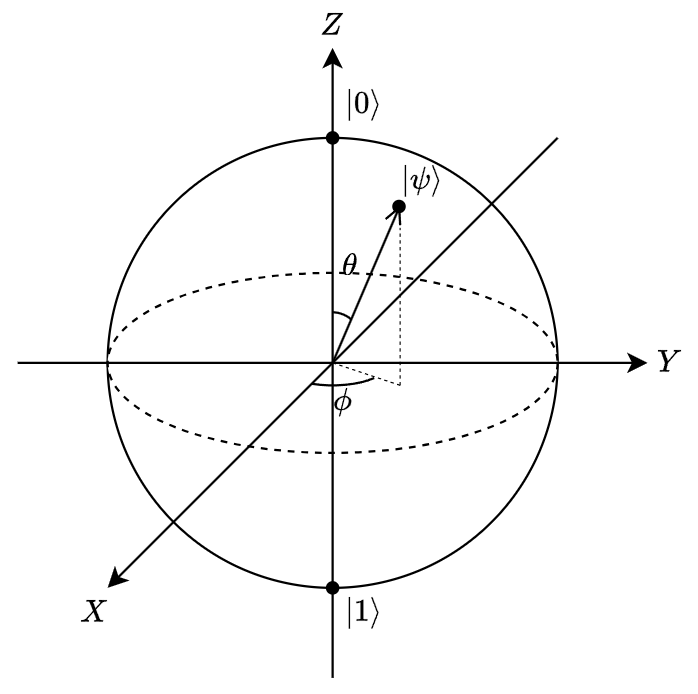
量子ビットの状態は三角関数と大きさ$1$の複素数$e^{i\phi_\alpha}$、$e^{i\phi_\beta}$を用いて以下のように変形できます。
$$\ket{\psi}=e^{i\phi_\alpha}\cos\left(\frac{\theta}{2}\right)\ket0+e^{i\phi_\beta}\sin\left(\frac{\theta}{2}\right)\ket1=e^{i\phi_\alpha}\left\{\cos\left(\frac{\theta}{2}\right)\ket0+e^{i(\phi_\beta-\phi_\alpha)}\sin\left(\frac{\theta}{2}\right)\ket1\right\}\tag{14}$$
ここで全体に係る$e^{i\phi_\alpha}$(グローバル位相)は$0$と$1$の確率に影響を与えないため、物理的な意味がありません。(他の状態と重ね合わせたときは相対位相となるため、状態の定義としては必要です)
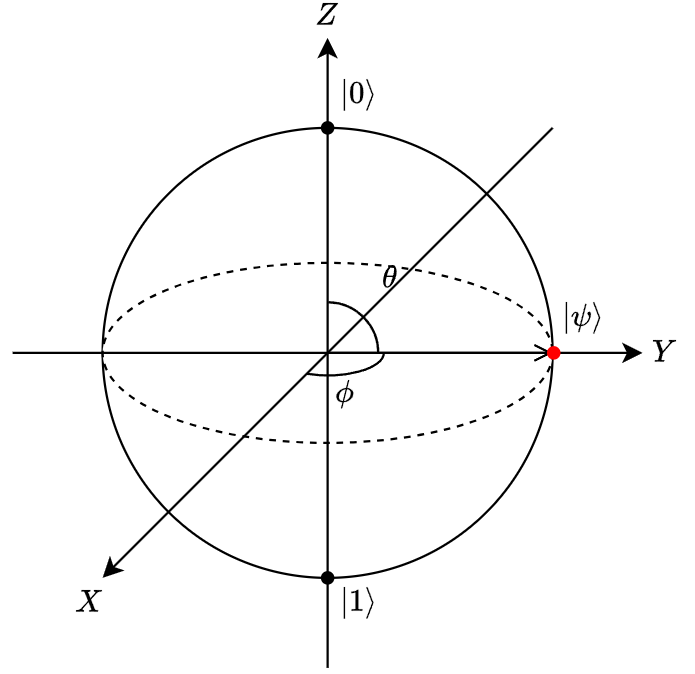
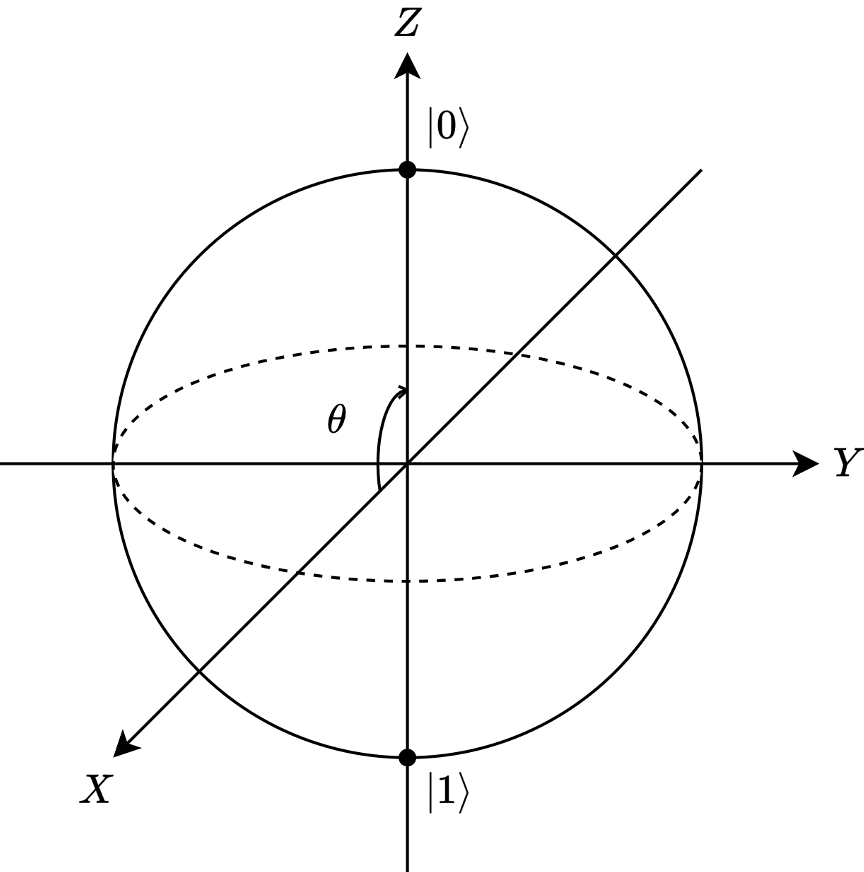
そのため、グローバル位相を無視し、$\phi=\phi_\beta-\phi_\alpha$とすると、$\ket{\psi}$は図2の球面上の点に対応します。この球をブロッホ球といいます。
いくつかの状態を例として考えてみましょう。
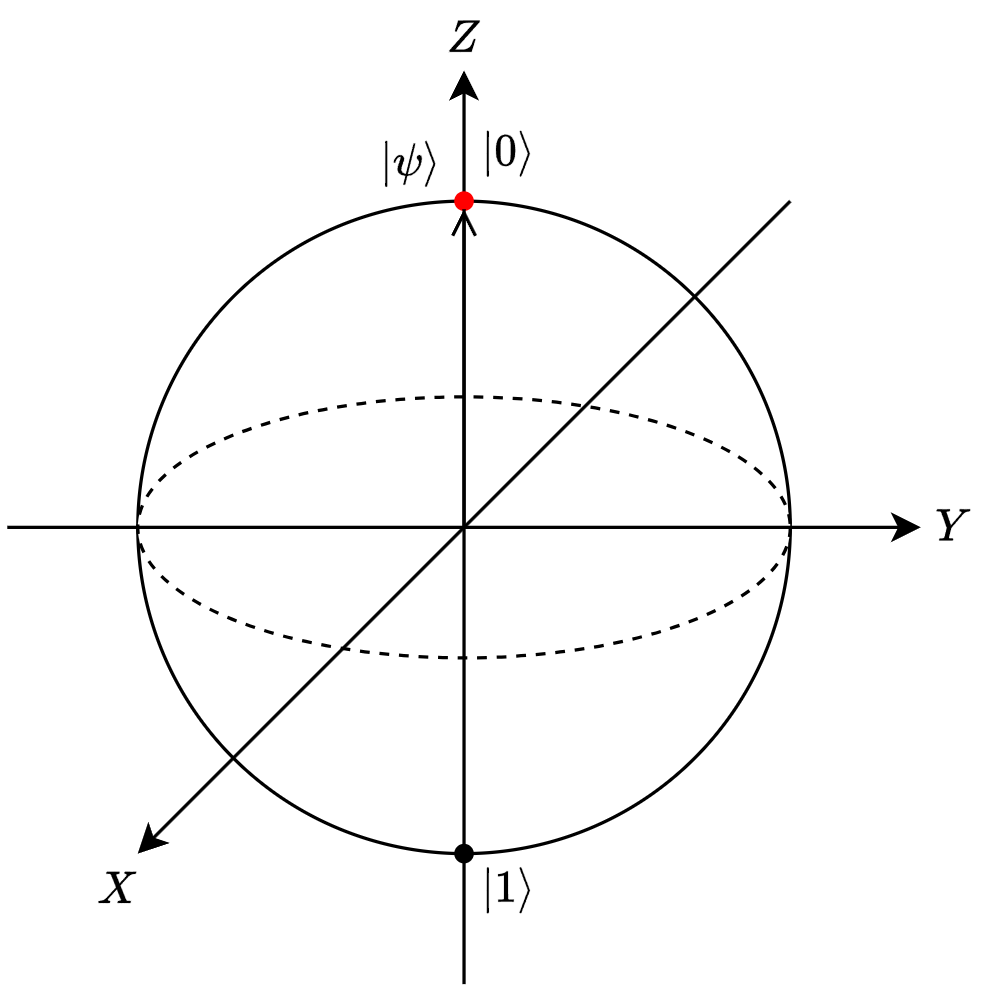
$\ket{\psi}=\left(\begin{matrix}1\\0\\\end{matrix}\right)$のとき、$\theta=0、\phi=0$なので図3の点に対応します。
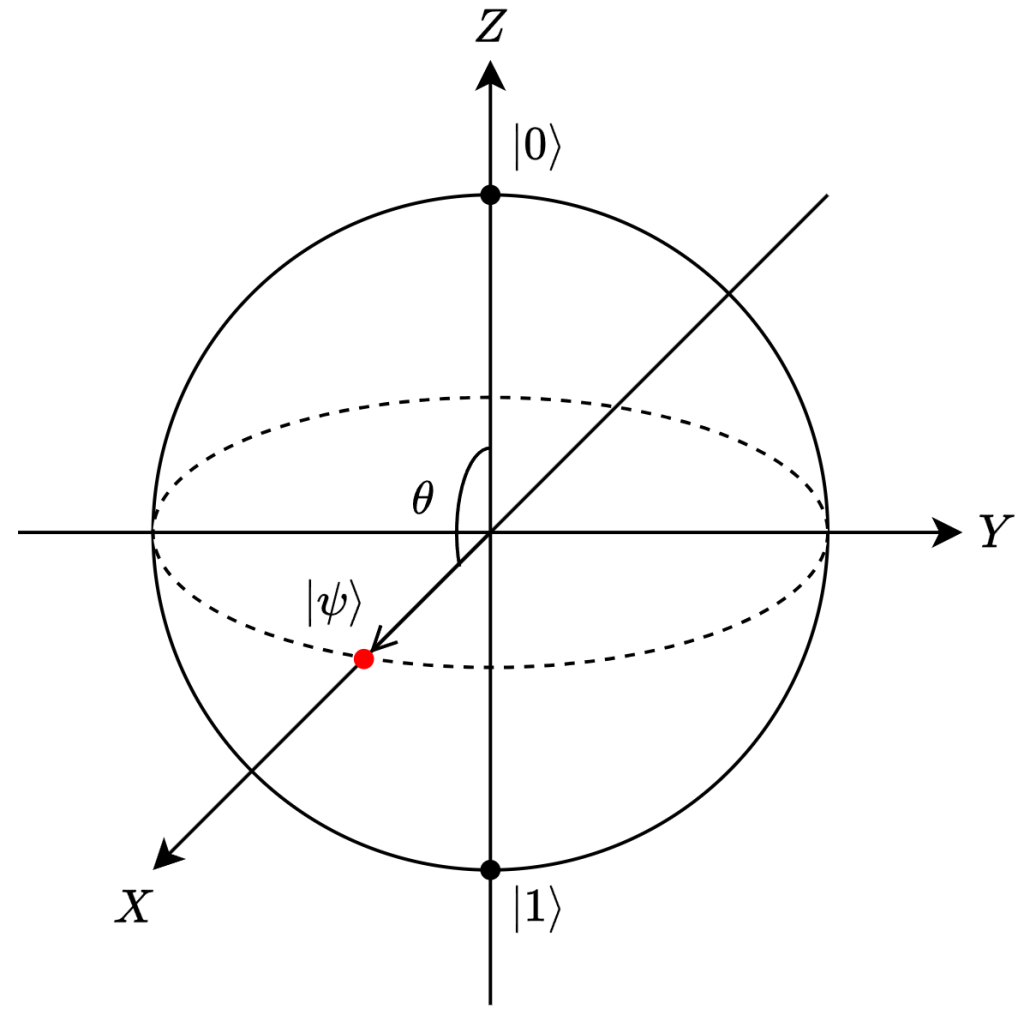
$\ket{\psi}=\left(\begin{matrix}\frac{1}{\sqrt{2}}\\\frac{1}{\sqrt{2}}\\\end{matrix}\right)$のとき、$\theta=\frac{\pi}{2}、\phi=0$なので図4の点に対応します。
$\ket{\psi}=\left(\begin{matrix}\frac{1}{\sqrt{2}}\\\frac{i}{\sqrt{2}}\\\end{matrix}\right)$のとき、$\theta=\frac{\pi}{2}、\phi=\frac{\pi}{2}$なので図5の点に対応します。
純粋状態と混合状態
これまで扱ってきた$\ket{\psi}$で表されるような量子状態を純粋状態というのに対し、量子ビットの状態が確率的に混ざり合った状態を混合状態といいます。
例として図6のように、ノイズなどの影響により$50$%でビットが反転($50$%で$X$ゲートが作用)する状況を考えます。
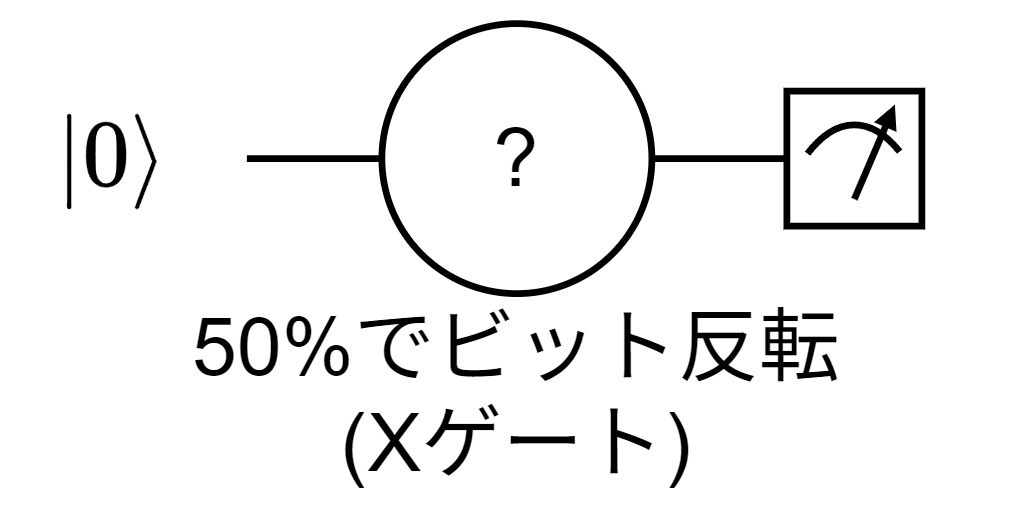
このとき、測定前の状態は$50$%で$\ket0$、$50$%で$\ket1$となり、測定では$0$と$1$が$1:1$の確率で得られます。
このような状態を混合状態といいます。
このような混合状態では(我々の考慮しきれない外的要因による)ノイズ等によって量子の状態と測定結果が決定しないのに対し、純粋状態では量子の状態は確定しており、量子の不確定性から測定結果が決定しないため、この例と$\ket{\psi}=\frac{1}{\sqrt{2}}\left(\begin{matrix}1\\1\\\end{matrix}\right)$は明確に違う状態であるといえます(図7)。
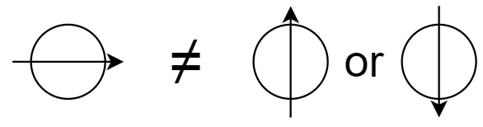
どちらも $0$ と $1$ が $\frac{1}{2}$ ずつ出るためこのまま測定をしても区別できませんが、$H=\frac{1}{\sqrt{2}}\begin{pmatrix}1&1\\1&-1\end{pmatrix}$のゲートを掛けると、$\ket{\psi}$ については $$H\ket{\psi}=\frac{1}{\sqrt{2}}\begin{pmatrix}1&1\\1&-1\end{pmatrix}\frac{1}{\sqrt{2}}\begin{pmatrix}1\\1\end{pmatrix}=\frac{1}{2}\begin{pmatrix}2\\0\end{pmatrix}=\begin{pmatrix}1\\0\end{pmatrix}=\ket{0}\tag{15}$$ となり、必ず $0$ が出ます。一方、混合状態は元が $\ket{0}$ であれば $$H\ket{0}=\frac{1}{\sqrt{2}}\begin{pmatrix}1&1\\1&-1\end{pmatrix}\begin{pmatrix}1\\0\end{pmatrix}=\frac{1}{\sqrt{2}}\begin{pmatrix}1\\1\end{pmatrix}\tag{16}$$ 元が $\ket{1}$ であれば $$H\ket{1}=\frac{1}{\sqrt{2}}\begin{pmatrix}1&1\\1&-1\end{pmatrix}\begin{pmatrix}0\\1\end{pmatrix}=\frac{1}{\sqrt{2}}\begin{pmatrix}1\\-1\end{pmatrix}\tag{17}$$ となり、どちらの場合も $0$ と $1$ が $\frac{1}{2}$ ずつ出るため、$H$ を掛けた後も $\frac{1}{2}$ ずつのままです。
密度演算子
純粋状態と混合状態を統一的に表現する方法として、以下の式で表される密度演算子表現があります。
$$\rho=\sum\nolimits_{i}{p_i|\left. \psi_i\right\rangle\left\langle\psi_i\right.|}\tag{18}$$
ここで$p_i$は$\ket{\psi_i}$の状態となる確率、$\bra{\psi_i}$は$\ket{\psi_i}$の共役転置です。
$\rho$は行列となり、純粋状態$\ket{\psi}=\left(\begin{matrix}\alpha\\\beta\\\end{matrix}\right)$のとき、
$$\rho=\binom{\alpha}{\beta}\left(\begin{matrix}\alpha^\ast&\beta^\ast\end{matrix}\right)=\left(\begin{matrix}{|\alpha|}^2&\alpha\beta^\ast\\\alpha^\ast\beta&{|\beta|}^2\end{matrix}\right)\tag{19}$$
となります。対角成分が$1$と$0$の測定される確率になるため、これを混合状態に拡張したときに、その純粋状態が得られる確率をかけて足し合わせれば最終的な測定確率に一致します。
非対角成分に関しては$\alpha$と$\beta$の位相差に関する情報を持っています。また、グローバル位相の情報は共役転置をかけることで無くなっています。($e^{i\phi}\ket{\psi}(e^{i\phi}\ket{\psi})^*=e^{i\phi}\ket{\psi}e^{-i\phi}\bra{\psi}$)
ゲートの適用は以下のように記述します。
$$\rho\prime=U\rho\operatorname{U}^†\tag{20}$$
ここで$U^\dagger$とは$U$の共役転置行列$ \begin{pmatrix} a & b \\ c & d \end{pmatrix}^\dagger = \begin{pmatrix} a^* & c^* \\ b^* & d^* \end{pmatrix} $です。$\ket{\psi}$にゲート$U$を適用するとき$U\ket{\psi}$と書けることから、$U\ket{\psi}(U\ket{\psi})^\dagger = U\ket{\psi}\bra{\psi}U^\dagger$と導けます。
また定義からも明らかなように、密度演算子$\rho$は自身の共役転置行列が自身に一致するエルミート行列になっています。
パウリ演算子
パウリ演算子は以下の行列で定義されます。
$$X=\left(\begin{matrix}0&1\\1&0\end{matrix}\right), Y=\left(\begin{matrix}0&-i\\i&0\end{matrix}\right), Z=\left(\begin{matrix}1&0\\0&-1\end{matrix}\right)\tag{21}$$
これらパウリ演算子は自身の共役転置行列が自身に一致するエルミート行列であり、また自身の共役転置行列が自身の逆行列に一致するユニタリ行列でもあります。つまり、自分自身が自分の逆行列であるため、$X^2=I, Y^2=I, Z^2=I$が成り立ちます。
密度演算子空間
密度演算子空間を考えるにあたって、密度演算子はエルミート行列であるため、まず$2\times2$のエルミート行列全体が張る空間を考えてみます。
$2\times2$のエルミート行列$A$は$A^†=A$なので、実数$r_1,r_2$、複素数$\alpha$を用いて以下のように表せます。
$$A=\left(\begin{matrix}a&b\\c&d\end{matrix}\right)=\left(\begin{matrix}a^*&c^*\\b^*&d^*\end{matrix}\right)=\left(\begin{matrix}r_1&\alpha\\\alpha^*&r_2\end{matrix}\right)\tag{22}$$
$a=a^*,d=d^*$より$a,d$は実数、$b=c^*$より$c$と$b$はそれぞれの複素共役な複素数となることがわかります。
複素数の自由度は$2$であることから、$2\times2$のエルミート行列の自由度は$4$であると言えます。
エルミート行列空間に対して上記のパウリ演算子+単位行列$I$を考えてみます。
$$I=\left(\begin{matrix}1&0\\0&1\end{matrix}\right), X=\left(\begin{matrix}0&1\\1&0\end{matrix}\right), Y=\left(\begin{matrix}0&-i\\i&0\end{matrix}\right), Z=\left(\begin{matrix}1&0\\0&-1\end{matrix}\right)\tag{23}$$
$I$と$Z$の定数倍($r_II+r_ZZ$)によって対角成分の実数$r_1,r_2$を、$X$と$Y$の定数倍($r_XX+r_YY$)によって対角成分以外の複素数$\alpha,\alpha^*$を表現できることがわかります。つまり、パウリ演算子+単位行列$I$は$2\times2$エルミート行列空間の基底になると言えます。
$$r_II+r_XX+r_YY+r_ZZ=\left(\begin{matrix}r_I&0\\0&r_I\end{matrix}\right)+\left(\begin{matrix}0&r_X\\r_X&0\end{matrix}\right)+\left(\begin{matrix}0&-ir_Y\\ir_Y&0\end{matrix}\right)+\left(\begin{matrix}r_Z&0\\0&-r_Z\end{matrix}\right)\tag{24}$$
$$=\left(\begin{matrix}r_I+r_Z&r_X-ir_Y\\r_X+ir_Y&r_I-r_Z\end{matrix}\right)\tag{25}$$
$r_I=\frac{r_1+r_2}{2}$,$r_Z=\frac{r_1-r_2}{2}$とすると
$$=\left(\begin{matrix}r_1&r_X-ir_Y\\r_X+ir_Y&r_2\end{matrix}\right)\tag{26}$$
これらの基底が直交していることも簡単に確認できます。行列空間の内積にはヒルベルト・シュミット内積
$$\langle A,B\rangle=Tr(A^\dagger B)\tag{27}$$
を用います。$I,X,Y,Z$はエルミート行列なので、これらについては$A^\dagger=A$となり、$\langle A,B\rangle=Tr(AB)$と書けます。以下に$X$と$Y$の内積を示します。
$$\langle X,Y\rangle=Tr(X^\dagger Y)=Tr(XY)=Tr\left(\left(\begin{matrix}0&1\\1&0\end{matrix}\right)\left(\begin{matrix}0&-i\\i&0\end{matrix}\right)\right)=Tr\left(\left(\begin{matrix}i&0\\0&-i\end{matrix}\right)\right)=0\tag{28}$$
自身との内積は$I^2=I, X^2=I, Y^2=I, Z^2=I$より$Tr(I)=2$となり、全基底において$2$になるため、自身との内積が$1$になるように大きさをそろえて以下の式でエルミート行列空間を表現できます。
$$A=\frac{1}{2}(r_II+r_XX+r_YY+r_ZZ)\tag{29}$$
ここで量子ビットの状態の密度演算子表現はエルミート行列となることを思い出すと、上記の基底を用いて密度演算子空間を表せると考えられます。
密度演算子の定義を改めて確認しましょう。ここでは簡単のために純粋状態の密度演算子を確認します。
$$\rho=\binom{\alpha}{\beta}\left(\begin{matrix}\alpha^\ast&\beta^\ast\end{matrix}\right)=\left(\begin{matrix}{|\alpha|}^2&\alpha\beta^\ast\\\alpha^\ast\beta&{|\beta|}^2\end{matrix}\right)\tag{30}$$
この行列がエルミート行列になることは自明です。また、対角成分の和が確率の総和になるため、トレースが$1$となります。したがって、密度演算子はエルミート性とトレース$1$を満たす行列として表すことができます。よって$r_I=1$で固定した以下の式によって密度演算子空間を表現できます。
$$\rho=\frac{1}{2}(I+r_XX+r_YY+r_ZZ)\tag{31}$$
式(31)を行列で書くと、
$$\rho=\frac{1}{2}\left(\begin{matrix}1+r_Z&r_X-ir_Y\\r_X+ir_Y&1-r_Z\end{matrix}\right)\tag{32}$$
となります。この行列の固有値を計算すると、
$$\lambda_\pm=\frac{1}{2}\left(1\pm\sqrt{r_X^2+r_Y^2+r_Z^2}\right)\tag{33}$$
となります。ここで、密度演算子の固有値は確率として解釈できるため、負の値になってはいけません。特に小さい方の固有値
$$\lambda_-=\frac{1}{2}\left(1-\sqrt{r_X^2+r_Y^2+r_Z^2}\right)\tag{34}$$
が$0$以上である必要があります。そのため、
$$r_X^2+r_Y^2+r_Z^2\leq1\tag{35}$$
という制約が得られます。このように、測定確率が負にならないようにするために密度演算子には半正定値性という制約が必要になります。
そして、この制約は$(r_X,r_Y,r_Z)$が半径$1$の球面とその内側にあることを意味します。
以上より、エルミート行列空間の自由度は$4$でしたので、トレース$1$という制約によって密度演算子空間の自由度は$3$に下がり、半正定値性によって$(r_X,r_Y,r_Z)$が半径$1$の球面とその内側に制限されます。
そしてこの空間は前述したブロッホ球空間と一致します。
少し例を見てみましょう。
$\ket{\psi}=\left(\begin{matrix}1\\0\\\end{matrix}\right)$のとき、密度演算子表現は以下の式で表現でき、図8の点に対応します。
$$\rho=\binom{1}{0}\left(\begin{matrix}1&0\end{matrix}\right)=\left(\begin{matrix}{1}&0\\0&{0}\end{matrix}\right)=\frac{1}{2}\left(\left(\begin{matrix}1&0\\0&1\end{matrix}\right)+\left(\begin{matrix}1&0\\0&-1\end{matrix}\right)\right)=\frac{1}{2}(I+1\cdot Z)\tag{36}$$
$\ket{\psi}=\frac{1}{\sqrt{2}}\binom{1}{e^{i\pi/4}}$($\theta=\frac{\pi}{2}、\phi=\frac{\pi}{4}$)のとき、$e^{-i\pi/4}=\frac{1-i}{\sqrt{2}}$なので密度演算子表現は以下の式で表現でき、図9の点に対応します。
$$\rho=\frac{1}{2}\binom{1}{e^{i\pi/4}}\left(\begin{matrix}1&e^{-i\pi/4}\end{matrix}\right)=\frac{1}{2}\left(\begin{matrix}1&\frac{1-i}{\sqrt{2}}\\\frac{1+i}{\sqrt{2}}&1\end{matrix}\right)=\frac{1}{2}\left(\left(\begin{matrix}1&0\\0&1\end{matrix}\right)+\frac{1}{\sqrt{2}}\left(\begin{matrix}0&1\\1&0\end{matrix}\right)+\frac{1}{\sqrt{2}}\left(\begin{matrix}0&-i\\i&0\end{matrix}\right)\right)=\frac{1}{2}(I+\frac{1}{\sqrt{2}}X+\frac{1}{\sqrt{2}}Y)\tag{37}$$
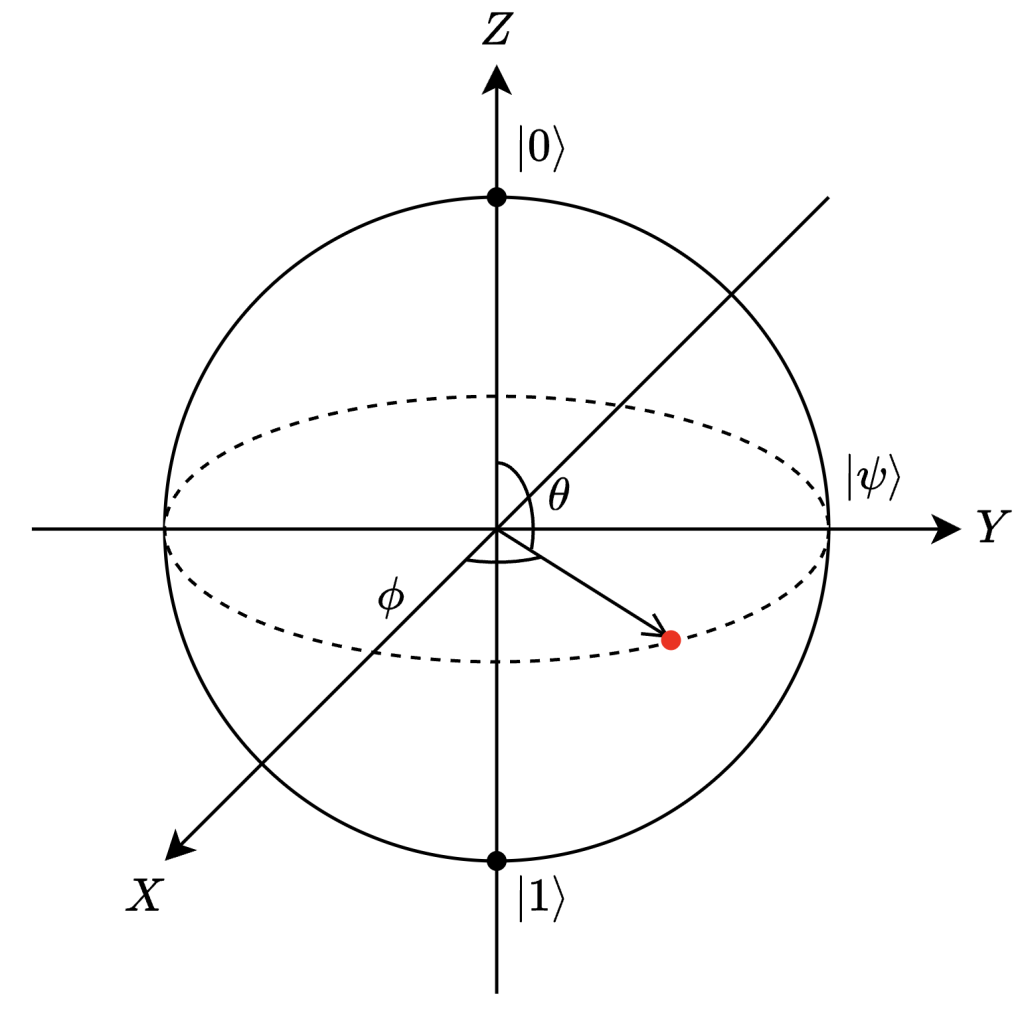
図8、図9のようにブロッホ球空間の座標と一致していることがわかります。
また、$N$量子ビット系において密度演算子空間の基底は$\{I,X,Y,Z\}^{\bigotimes N}$(テンソル積乗)で表せます。
$N=2$のときの例を見てみましょう。
$$
\rho
=
\frac{1}{2^2}
\Bigl(
I\otimes I
+ r_{XI}\, X\otimes I
+ r_{YI}\, Y\otimes I
+ r_{ZI}\, Z\otimes I
+ r_{IX}\, I\otimes X
+ r_{IY}\, I\otimes Y
+ r_{IZ}\, I\otimes Z
+ r_{XX}\, X\otimes X
+ r_{XY}\, X\otimes Y
+ r_{XZ}\, X\otimes Z
+ r_{YX}\, Y\otimes X
+ r_{YY}\, Y\otimes Y
+ r_{YZ}\, Y\otimes Z
+ r_{ZX}\, Z\otimes X
+ r_{ZY}\, Z\otimes Y
+ r_{ZZ}\, Z\otimes Z
\Bigr)\tag{38}
$$
このとき、自由度は$4^N-1$になります。
状態ベクトル表記のときの$\ket{\psi}=C_{00}\ket{00}+C_{01}\ket{01}+C_{10}\ket{10}+C_{11}\ket{11}$の自由度$2^N×2(複素数)-1(確率が1)-1(グローバル位相)$よりもオーダーがかなり大きくなっていますが、これは密度演算子表現によって混合状態も表現できるようになっているためです。
混合状態はブロッホ球空間の内部を含む球全体の点を取れますが、純粋状態はブロッホ球空間の球面上の点しか取れないため、混合状態も表現できる密度演算子表現の方が自由度が大きくなります。
パラメトリックゲート
パラメトリックゲートは、ゲートの行列が連続パラメータに依存する量子ゲートのことです。
ゲートとなる条件はユニタリ性であるため、パラメトリックゲートは任意のパラメータの値においてユニタリ性を保証する必要があります。
これらを満たすユニタリ行列は$A$をエルミート行列、$\theta$をパラメータとして以下のように表せます。
$$U(\theta)=e^{-iA(\theta)}\tag{39}$$
本論文では$A(\theta)=\theta H$となる$\theta$に依存しないエルミート行列$H$を用いた以下の形を扱います。(導出はAppendixに記載しました)
$$U(\theta)=e^{-i\theta H}\tag{40}$$
このような$H$を生成子と呼びます。
$e$の指数に行列がありますが、このような数の行列乗は以下のようなマクローリン展開された形で定義されます。
$$e^{-i\theta H}=\sum_{n=0}^{\infty}{\frac{1}{n!}{(-i\theta H)}^n}\tag{41}$$
例として$R_Y\left(\theta\right)=e^{-i\frac{\theta}{2}Y}$を見てみましょう。
マクローリン展開で表した形を奇数乗、偶数乗で分けると、$Y^2=I$なので以下のようになります。
$${R_Y(\theta)=e}^{-\frac{i\theta}{2}Y}=\sum_{n=0}^{\infty}{\frac{1}{n!}{(-\frac{i\theta}{2}Y)}^n}\ =\left(\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k)!}{(\frac{\theta}{2})}^{2k}}\right)I-i\left(\sum_{k=0}^{\infty}{\frac{\left(-1\right)^k}{\left(2k+1\right)!}\left(\frac{\theta}{2}\right)^{2k+1}}\right)Y\tag{42}$$
また、$\sin(\frac{\theta}{2})=\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k+1)!}{(\frac{\theta}{2})}^{2k+1}}$、$\cos(\frac{\theta}{2})=\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k)!}{(\frac{\theta}{2})}^{2k}}$なので
$$=\cos{\left(\frac{\theta}{2}\right)}I-i\sin\left(\frac{\theta}{2}\right)Y=\cos{\left(\frac{\theta}{2}\right)}\left(\begin{matrix}1&0\\0&1\end{matrix}\right)-i\sin\left(\frac{\theta}{2}\right)\left(\begin{matrix}0&-i\\i&0\end{matrix}\right)=\left(\begin{matrix}\cos{\left(\frac{\theta}{2}\right)}&-\sin\left(\frac{\theta}{2}\right)\\\sin\left(\frac{\theta}{2}\right)&\cos{\left(\frac{\theta}{2}\right)}\end{matrix}\right)\tag{43}$$
得られた行列は$2$次元回転行列の形をしていますが、実はこれはブロッホ球上で$Y$軸まわり角度$\theta$の回転として解釈できます。
より一般に、生成子として$\frac{r_XX+r_YY+r_ZZ}{2}$を選んだパラメトリックゲートは、ベクトル$(r_X,r_Y,r_Z)$の大きさが$1$のとき、ブロッホ球上の$(r_X,r_Y,r_Z)$を軸とした角度$\theta$の回転ゲートになります。
オブザーバブル
オブザーバブルとは量子系から観測できる情報のことです。
量子コンピュータで直接観測できるのは$|0\rangle$と$|1\rangle$の確率のみであり、これはブロッホ球空間の$Z$を測定していることに対応します。
つまり、$Z$測定に帰着できるもの全てがオブザーバブルであるといえます。
例として$X$測定を見てみましょう。
図10のように$Y$軸回転ゲート$R_Y(\theta)$を$\theta = -\frac{\pi}{2}$で適用すると$X$軸方向を$Z$軸方向に回転させることができるため、その後$Z$測定を行うことでゲート適用前の$X$を測定できます。
このように、任意のエルミート行列はユニタリ変換で対角化できるため、同様に基底変換ゲートを適用することで$Z$測定に帰着できます。
つまりオブザーバブルとはエルミート行列であり、${I,X,Y,Z}$で表せるということがわかります。(多量子ビット系では$\{I,X,Y,Z\}^{\bigotimes N}$)
期待値
あるオブザーバブル$B$に関して状態$\rho$を測定をしたときの期待値$\left\langle B\right\rangle$は、$\rho$と$B$の内積で記述できます。
$$\left\langle B\right\rangle_\rho=Tr(B\rho)\tag{44}$$
例として$XZ$平面上の純粋状態$\rho=\frac{1}{2}(I+\sin(\theta)X+\cos(\theta)Z)$に対して$Z$測定を行うときを考えてみます。
$\left\langle Z\right\rangle_\rho=Tr(Z\rho)=Tr(\frac{1}{2}(ZI+\sin(\theta)ZX+\cos(\theta)ZZ))=\frac{1}{2}(Tr(ZI)+\sin(\theta)Tr(ZX)+\cos(\theta)Tr(ZZ))$
$Z$に対して$I,X$は直交するため内積は$0$、自身との内積は$1$なので
$$\left\langle Z\right\rangle_\rho=\cos(\theta)\tag{45}$$
となります。
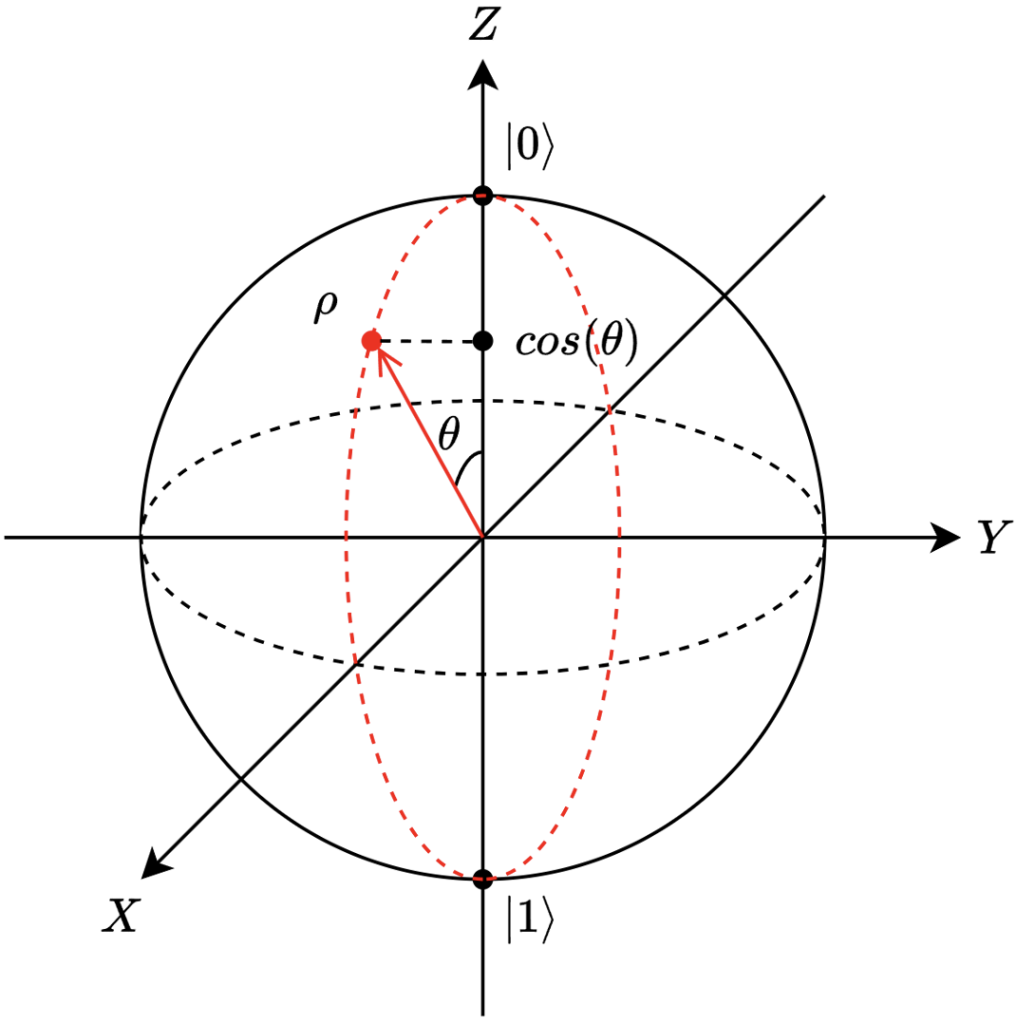
図11のように、ベクトル$(r_X,r_Y,r_Z)$の大きさが$1$のとき、その状態の期待値を得る操作はオブザーバブルに対する状態$\rho$の射影をとる操作に対応します。
パラメータシフトルール
パラメータシフトルールとは、量子機械学習において、三角関数の特性を利用して勾配を得る方法です。
生成子$P$がパウリ型(パウリ演算子の定数倍またはテンソル積)のパラメトリックゲート$U(\theta)$の$\theta$微分に使え、以下の式で表されます。
$$\frac{\partial\left\langle B\right\rangle_\rho\left(\theta\right)}{\partial\theta}=\frac{1}{2}\left\{\left\langle B\right\rangle_\rho\left(\theta+\frac{\pi}{2}\right)-\left\langle B\right\rangle_\rho\left(\theta-\frac{\pi}{2}\right)\right\}\tag{46}$$
ここで、$B$は選択したオブザーバブル、$\left\langle B\right\rangle_\rho$は$\rho$における$B$の期待値です。
$$\left\langle B\right\rangle_\rho(\theta)=Tr(B\rho(\theta))\tag{47}$$
$\rho(\theta)$は入力状態$\rho_{in}$にパラメータ$\theta$を持つゲート$U(\theta)$を作用させて得られた状態です。
$$\rho\left(\theta\right)=U(\theta)\rho_{in}U^\dagger(\theta)\tag{48}$$
そもそもなぜこのような手続きが必要なのかを確認しておきます。求めたい量は
$$\frac{\partial\left\langle B\right\rangle_\rho\left(\theta\right)}{\partial\theta}=Tr\left(B\frac{\partial\rho\left(\theta\right)}{\partial\theta}\right)\tag{49}$$
ですが、$\partial\rho(\theta)/\partial\theta$ は量子状態ではありません。密度演算子空間は $Tr(\rho)=1$、すなわちパウリ基底で書いたときの $I$ の係数が $1$ に固定された空間でしたが、この係数は $\theta$ によらない定数なので、微分すると消えてしまうためです。実際、$\rho(\theta)=\frac{1}{2^N}\left(I+\sum_{P\neq I}r_P(\theta)P\right)$ と書けば
$$\frac{\partial\rho\left(\theta\right)}{\partial\theta}=\frac{1}{2^N}\sum_{P\neq I}\frac{\partial r_P\left(\theta\right)}{\partial\theta}P\tag{50}$$
となり、$I$ 成分を持ちません。これはブロッホ球上を動く点に対する速度ベクトルであって、点そのものではないということです。量子コンピュータにできるのは状態を用意してその上でオブザーバブルの期待値を推定することだけなので、状態でないものに対する期待値を直接測る回路は作れません。パラメータシフトルールは、この微分を実際に用意できる $2$ つの状態 $\rho\left(\theta\pm\frac{\pi}{2}\right)$ 上の期待値の差として書き直す手続きです。
この手法で得られた勾配は、微分の極限操作を近似で計算する数値差分とは異なり、解析的に正しい値を得ることができます。
生成子$P$がパウリ演算子そのものの場合を考えて上記の式が正しいかを確認してみましょう。
まずゲート$U(\theta)$はパウリ演算子の性質$P^2=I$から、マクローリン展開で表した形を奇数乗、偶数乗で分けると次のように変形できます。
$$U\left(\theta\right)=e^{-\frac{i\theta}{2}P}=\sum_{n=0}^{\infty}{\frac{1}{n!}{(-\frac{i\theta}{2}P)}^n}=\left(\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k)!}{(\frac{\theta}{2})}^{2k}}\right)I-i\left(\sum_{k=0}^{\infty}{\frac{\left(-1\right)^k}{\left(2k+1\right)!}\left(\frac{\theta}{2}\right)^{2k+1}}\right)P\tag{51}$$
$\sin(\frac{\theta}{2})=\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k+1)!}{(\frac{\theta}{2})}^{2k+1}}$、$\cos(\frac{\theta}{2})=\sum_{k=0}^{\infty}{\frac{{(-1)}^k}{(2k)!}{(\frac{\theta}{2})}^{2k}}$なので
$$=\cos{\left(\frac{\theta}{2}\right)}I-i\sin\left(\frac{\theta}{2}\right)P\tag{52}$$
次に入力状態$\rho_{in}$に$U(\theta)$を作用させた状態$\rho$を次のように変形します。(パウリ演算子$P$と$I$は共役転置が自身に一致するため、係数に$i$がある$\sin$の項だけ符号が反転)
$$\rho\left(\theta\right)=U\left(\theta\right)\rho_{in}U^\dagger\left(\theta\right)=\left(\cos{\left(\frac{\theta}{2}\right)}I-i\sin\left(\frac{\theta}{2}\right)P\right)\rho_{in}\left(\cos{\left(\frac{\theta}{2}\right)}I+i\sin\left(\frac{\theta}{2}\right)P\right)\tag{53}$$
$$\ =\rho_{in}\cos^2{\left(\frac{\theta}{2}\right)}+P\rho_{in}P\sin^2{\left(\frac{\theta}{2}\right)}+\left(\rho_{in}P-P\rho_{in}\right)i\sin\left(\frac{\theta}{2}\right)\cos\left(\frac{\theta}{2}\right)\tag{54}$$
この各項を三角関数の倍角の公式で変形して整理すると以下のようになります。
$$\ =\rho_{in}\frac{1+\cos(\theta)}{2}+P\rho_{in}P\frac{1-\cos(\theta)}{2}+\left(\rho_{in}P-P\rho_{in}\right)i\frac{\sin\left(\theta\right)}{2}\tag{55}$$
$$\ =\left(\frac{\rho_{in}+P\rho_{in}P}{2}\right)+\left(\frac{\rho_{in}-P\rho_{in}P}{2}\right)\cos{\left(\theta\right)}+\left(\frac{\rho_{in}P-P\rho_{in}}{2}i\right)\sin(\theta)\tag{56}$$
この$\rho$における$B$の期待値は以下のようになり、トレースをとっている各係数にはパラメータ$\theta$が含まれず、周期の揃った三角関数の線型結合になっていることがわかります。
$$\left\langle B\right\rangle_\rho\left(\theta\right)=Tr\left(B\rho\left(\theta\right)\right)=Tr\left(B\left(\frac{\rho_{in}+P\rho_{in}P}{2}\right)\right)\tag{57}$$
$$+Tr\left(B\left(\frac{\rho_{in}-P\rho_{in}P}{2}\right)\right)\cos{\left(\theta\right)}+Tr\left(B\left(\frac{\rho_{in}P-P\rho_{in}}{2}i\right)\right)\sin(\theta)\tag{58}$$
周期が揃っているので、以下のようにパラメータ$\theta$を$\frac{\pi}{2}$ずらせば$\sin$、$\cos$の項は微積分が表現できます。
$$\cos{\left(\theta\pm\frac{\pi}{2}\right)}=\mp\sin{\left(\theta\right)},\hspace{5pt}\sin{\left(\theta\pm\frac{\pi}{2}\right)}=\pm\cos\left(\theta\right)\tag{59}$$
よって式(60)のように$\theta+\frac{\pi}{2}$したものから$\theta-\frac{\pi}{2}$したものを引くことにより、定数項のみが打ち消され、$\sin$、$\cos$の項は微分された状態で$2$倍になって残るため、$\frac{1}{2}$をかけることで$\left\langle B\right\rangle_\rho(\theta)$における$\theta$微分が表現できます。
$$\frac{\partial\left\langle B\right\rangle_\rho\left(\theta\right)}{\partial\theta}=\frac{1}{2}\left\{\left\langle B\right\rangle_\rho\left(\theta+\frac{\pi}{2}\right)-\left\langle B\right\rangle_\rho\left(\theta-\frac{\pi}{2}\right)\right\}\tag{60}$$
提案手法
本論文ではパラメータを持った量子回路全体を学習モデルとして扱い、パラメータの反復的な更新により与えられたタスクを学習する枠組みを提案しています。
最適化手順は以下の通りです。
- 入力データ$\bm{x_i}$(古典データ)を入力ゲート$U_{in}(\bm{x_i})$のパラメータとし、初期状態に作用させることにより量子状態$\ket{\psi_{in}(\bm{x_i})}$に$\bm{x_i}$の情報を落とし込む
- 状態$\ket{\psi_{in}(\bm{x_i})}$にパラメータ$\bm{\theta}$に依存したゲート$U(\bm{\theta})$を作用させることにより出力状態$\ket{\psi_{out}(\bm{x_i},\bm{\theta})}$を得る
- 出力状態$\ket{\psi_{out}(\bm{x_i},\bm{\theta})}$から期待値$\left\langle B\right\rangle(\bm{x_i},\bm{\theta})$を測定し、必要に応じて定義域や値域の調整、確率問題ならソフトマックスやシグモイドを通して最終的なモデルの出力$y(\bm{x_i},\bm{\theta})=F(⟨B⟩(\bm{x_i},\bm{\theta}))$を得る
- 正解データ$f(\bm{x_i})$とモデルの出力$y(\bm{x_i},\bm{\theta})$から定義されるコスト関数$L(\theta)$を最小化する$\theta=\theta^{\prime}$を求めて更新
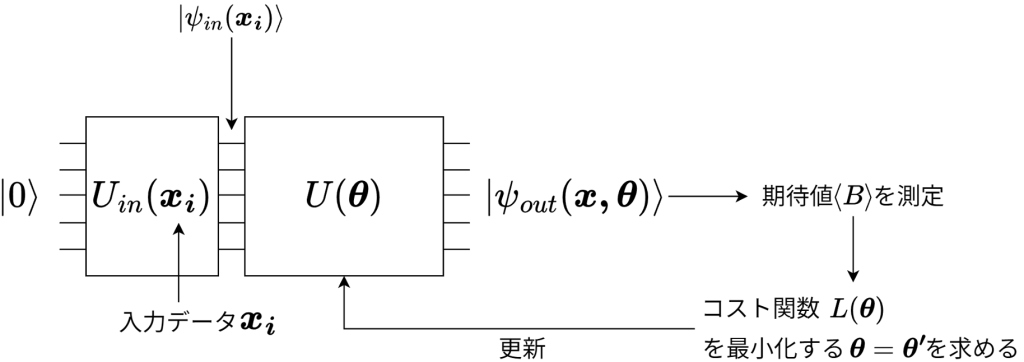
全体の流れは図12のとおりです。以下で各手順を詳しく解説します。
符号化
まず、入力古典データを量子データに変換します。
初期化された量子ビットが入力データ$x_i$の情報を持つように量子回路$U_{in}(\theta_{in})$のパラメータを決め、初期状態(固定)をその量子回路に通すことで入力状態$\ket{\psi_{in}}(x_i)$を作ります。
例として${U_{in}=R}_y\left({\sin}^{-1}x_i\right)$で定義される$Y$軸回転ゲートを考えてみましょう。(ここでは$\theta_{in}={\sin}^{-1}x_i$)
初期状態$\ket{0}$に対して作用させるとブロッホ球空間では図13のように$Y$軸を軸として角度$\sin^{-1}x_i$回転し、$(r_X,r_Y,r_Z)=(x_i,0,\sqrt{1-x_i^2})$に位置する状態へと遷移します。
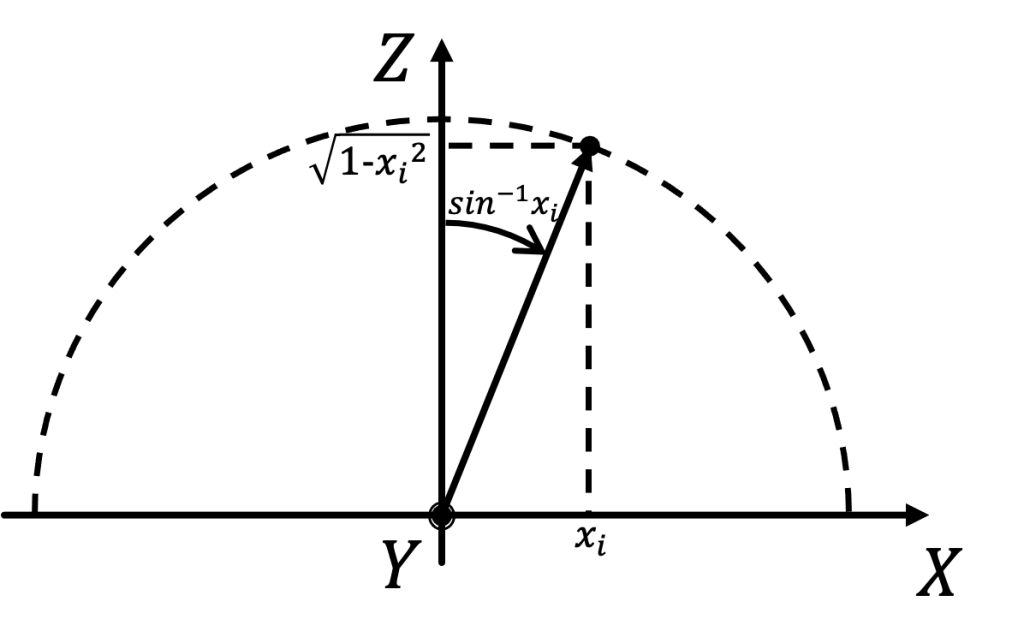
このように$r_X$と$r_Z$に入力古典データ$x_i$に依存した量が反映されていることがわかります。
1つの入力データの複数の量子ビットへの埋め込み
次に非線形項を生み出すために$1$つの入力古典データの情報を複数の量子ビットに埋め込むことを考えます。
上記の$Y$軸回転ゲートで$N$量子ビットに$x_i$を埋め込むとき、その$N$量子ビット系の状態$\rho_{in}(=\ket{\psi_{in}}\bra{\psi_{in}})$は以下の式で表せます。ここで$j$は量子ビットの番号です。(初期状態$\ket{0}$)
$$\rho_{in}\left(x_i\right)=\bigotimes_{j=1}^{N}{R_y\left({\sin}^{-1}x_i\right)\left|0\right\rangle\left\langle0\right|}R_y\left({\sin}^{-1}x_i\right)^\dagger=\frac{1}{2^N}\bigotimes_{j=1}^{N}\left[I+x_iX_j+\sqrt{1-{x_i}^2}Z_j\right]\tag{61}$$
これを展開すると非線形項が$x_i^N$まで現れます。
例として$N=2$のときを見てみましょう。
$$\begin{align}\rho_{in}\left(x_i\right)=\frac{1}{4}(I\otimes I+x_iI\otimes X_2+\sqrt{1-{x_i}^2}I\otimes Z_2\\+x_iX_1\otimes I+{\color{red}{x_i}^2X_1\otimes X_2}+{\color{red}x_i\sqrt{1-{x_i}^2}X_1\otimes Z_2}\\+\sqrt{1-{x_i}^2}Z_1\otimes I+{\color{red}x_i\sqrt{1-{x_i}^2}Z_1\otimes X_2}+{\color{red}{\sqrt{1-{x_i}^2}}^2Z_1\otimes Z_2})\tag{62}\end{align}$$
赤文字で示した項が非線形項です。$2$次の項まで現れていることがわかります。
この非線形項はモデルの表現力を大きく左右します。
例えば$f(x)=x^2$という関数のデータ$(x,f(x))$が$(0.5,0.25)$のように与えられたとき、$X_1\otimes X_2$軸に$x^2$の値が入ることになるので、$X_1\otimes X_2$軸を測定する軸($Z_1$軸)に回転させるようにパラメータ$\theta$を調整することで最適化を行うことができます。(図14は$3$次元空間に$X_1\otimes X_2$軸、$X_1$軸、$Z_1$軸を無理やり表現したものであり、回転軸等は正確ではありません)
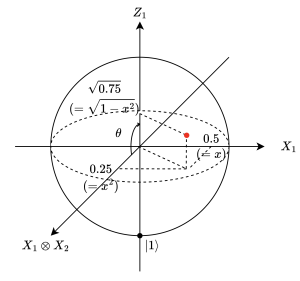
$f(x)=x^3$のときは埋め込みビット数$N=2$では完全に表現することはできません。加えて$\sin$などの関数は、マクローリン展開を考えてもわかるように、扱える非線形項の次数が上がれば上がるほど高い精度で最適化できます。
このように各軸の寄与をどれだけ測定軸方向に乗せるかをパラメータで操作することで最適化が行え、各軸に$x^N$の値が載っていることを考えると$N$が十分な大きさであればマクローリン展開できるような関数の近似はうまく行うことができると想像できます。
また、$2$次以上の係数を持つ項(赤文字の項)は量子ビットがエンタングルされていないと扱えないことが読み取れ、適切に量子ビットをエンタングルすることもモデルの表現力を損なわないために重要であると言えます。
多次元データの埋め込み
次に$d$次元のデータ$\bm{x_i}=\left(x_1,x_2,\ldots,x_d\right)$を扱うことを考えます。
以下の式で各成分をそれぞれ複数ビットに埋め込みます。ここでも$j$は量子ビットの番号です。
$$\rho_{in}\left(\bm{x}_\bm{i}\right)=\frac{1}{2^N}\bigotimes_{k=1}^{d}\left(\bigotimes_{j=1}^{n_k}\left[I+x_kX_j+\sqrt{1-x_k^2} Z_j\right]\right)\tag{63}$$
ここで$n_k$は$k$番目の成分を埋め込むビット数です。
これを展開すると各成分の積の項が$x_1^{n_1}x_2^{n_2}…x_k^{n_k}$まで現れます。
例えば$3$次元のデータ$\bm{x_i}=\left(x_1,x_2,x_3\right)$をそれぞれを埋め込むビット数$\bm{n}=\left(3,1,2\right)$で量子ビットに埋め込むとき、必要な量子ビット数は$3+1+2=6$となり、非線形項として$x_1^3x_2^1x_3^2$まで現れます。この様子を図15に示します。
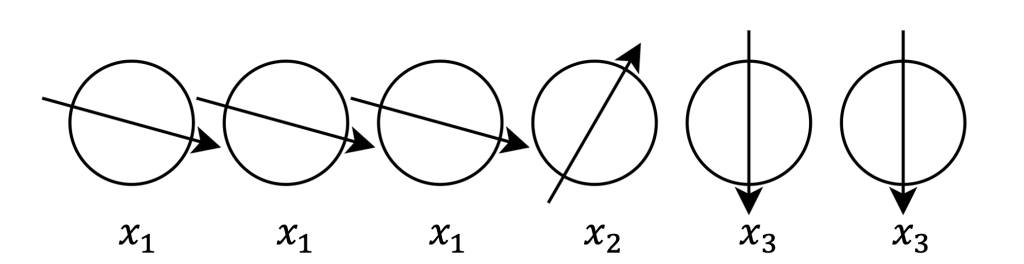
ここでもエンタングルが適切にされていないと各次元のデータが独立にしか扱えないため、例えば画像データなどの各ピクセルの接続情報などが適切に扱えないと考えられます。
このことからもやはりモデルの表現力を損なわないためにエンタングル状態を作ることが重要であると言えます。
パラメトリックゲートの適用
調整するパラメータ$\theta$を持ったゲート$U(\bm{\theta})$を入力状態$\ket{\psi_{in}}$に適用します。
ここで$U(\bm{\theta})$の設計は様々なものが考えられますが、先述した通りモデルの表現力を損なわないためにも、いかにしてエンタングル状態を作るかが重要であるといえます。
また、量子ビットは環境との相互作用によって状態の情報を失っていくため(デコヒーレンス)、回路の実行時間はコヒーレンス時間と呼ばれる時間スケールで制限されます。さらに各ゲートには有限の誤り率 $\epsilon$ があり、ゲート数を $G$ とすると回路全体が誤りなく実行される確率はおよそ $(1-\epsilon)^G\simeq e^{-\epsilon G}$ と指数的に減衰します。現在の量子コンピュータは誤り訂正を実装できる規模に達していないため、これらの誤りはそのまま測定結果に残ります。したがって回路の浅さも重要であるといえます。
例えば図16のような$U(\bm{\theta})$が考えられます。$7$次元のパラメータ$\bm{\theta}=\left(\theta_1,\theta_2,\ldots,\theta_7\right)$を持ち、$2$軸の回転ゲートによりブロッホ球空間全体を使用でき、$CNOT$ゲートによりエンタングルされた深さ$6$の回路です。
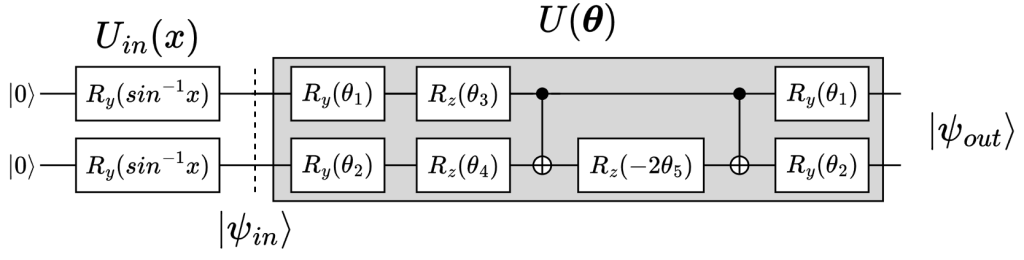
出力の決定
出力状態$\ket{\psi_{out}(\bm{x_i},\bm{\theta})}$に対して任意のオブザーバブル$B$の期待値$\left\langle B\right\rangle(\bm{x_i},\bm{\theta})$を測定します。
このときのオブザーバブル$B$に制限はありませんが、回路の浅さなどを考えると単一量子ビットの$Z$測定が適切といえます。どのオブザーバブルも最終的に単一量子ビットの$Z$測定に帰着させて測定するため、帰着するための回転ゲートが必要になるためです。
また、適切にエンタングルされていれば他のビットの情報を含んだビットができるため、全てのビットを測定する必要もありません。
ただし測定で得られる値は$-1$から$1$の間の数であるため、定義域や値域の調整、確率問題ならソフトマックスやシグモイドを通して最終的なモデルの出力$y(\bm{x_i},\bm{\theta})=F(⟨B⟩(\bm{x_i},\bm{\theta}))$とします。
コスト関数の最適化
まず、正解データ$f(\bm{x_i})$とモデルの出力$y(\bm{x_i},\bm{\theta})$からコスト関数$L(\theta)$を定義します。
このときのコスト関数は問題ごとに適切なものを選ぶ必要がありますが、例として以下のような$2$乗誤差が考えられます。
$$L\left(\bm{\theta}\right)={\sum_{\operatorname{i}}\left|\left|f\left(\bm{x}_\bm{i}\right)-y\left(\bm{x}_\bm{i},\bm{\theta}\right)\right|\right|}^2\tag{64}$$
このようなコスト関数の$\theta_j$微分は以下のようなチェインルールで表せます。
$$\frac{\partial L}{\partial\theta_j}=\sum_{i}{\frac{\partial L}{\partial y\left(\bm{x}_\bm{i},\bm{\theta}\right)}\frac{\partial y\left(\bm{x}_\bm{i},\bm{\theta}\right)}{\partial\left\langle B\left(\bm{x}_\bm{i},\bm{\theta}\right)\right\rangle}{\color{red}\frac{\partial\left\langle B\left(\bm{x}_\bm{i},\theta\right)\right\rangle}{\partial\theta_j}}}\tag{65}$$
赤文字の部分は量子回路を経由する因子なので、先述したパラメータシフトルールで計算します。残りの $2$ つの因子は、自分で関数形を選んで定義した古典的な関数であるコスト関数 $L$ と後処理 $F$ の微分なので、解析的に微分して古典コンピュータで評価できます。
この微分の計算結果を使って勾配降下法でパラメータを更新して最適化を行います。
実験設定
本論文では量子コンピュータ実機を用いた検証は行われておらず、古典コンピュータでの数値シミュレーションが行われました。
回路設計
図17に示すような量子ビット数$N=6$、回路深さ$D=6$の回路をシミュレーションします。ただし古典入力データから入力状態$\rho_{in}$を作る回路$U_{in}$はそれぞれの問題ごとに定義されるため、ここでは定義しません。
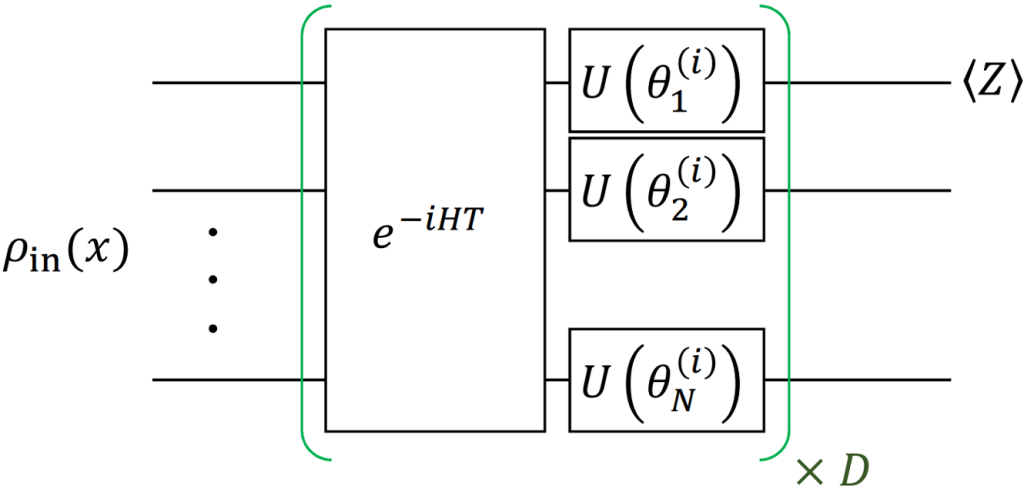
ここで、$U\left(\theta_j^{\left(i\right)}\right)$は以下で表される単一量子ビットの任意回転です。$2$軸の回転ゲートによりブロッホ球空間全体を使用できます。
$i$は量子回路の層を表し、$j$は量子ビットの番号を表します。
$$U\left(\theta_j^{\left(i\right)}\right)=R_X^{\left(j\right)}\left(\theta_{j1}^{\left(i\right)}\right)R_Z^{\left(j\right)}\left(\theta_{j2}^{\left(i\right)}\right)R_X^{\left(j\right)}\left(\theta_{j3}^{\left(i\right)}\right)\tag{66}$$
$e^{-iHT}$は以下の生成子$H$で表される横磁場イジングモデルによる時間発展です。これにより複雑なエンタングル状態を生成します。
$$H=\sum_{j=1}^{N}{a_jX_j}+\sum_{j=1}^{N}\sum_{k=1}^{j-1}J_{jk}Z_j\otimes Z_k\tag{67}$$
$T=10$、$J_{jk}$、$a_j$は$[-1,1]$からランダムに選択され以降の実験を通して固定します。ただし、異なる$J_{jk}$、$a_j$の値でも同様の結果が得られることは確認されているようです。
また、$\theta_j^{\left(i\right)}$の初期値は$[0,2\pi]$からランダムに選択され、測定されるオブザーバブルは$Z$のみとしています。
ノイズの付加
数値シミュレーションでは、オブザーバブルに対する期待値$⟨Z⟩$がサンプリングからではなく計算で正確な値が得られます。
しかし、量子コンピュータ実機では期待値を得るために複数回サンプリング(測定)を行い、期待値に収束させる、というプロセスが存在するため、サンプリングによる分散を再現するために以下の標準偏差$\sigma$で定義されるガウスノイズを計算で得られた期待値$⟨Z⟩$に加えます。
$$\sigma=\sqrt{\frac{2}{N_s}}\frac{1-\left\langle Z\right\rangle^2}{4}\tag{68}$$
ここで$N_s$はサンプル数です。
非線形関数の近似
問題定義
$f\left(x\right)=x^2,e^x,\sin{x},\left|x\right|$に対して先述の量子回路を学習モデルとして近似します。
まず、入力状態$\rho_{in}$は初期状態$\ket{0}$に対して以下の$U_{in}(x_i)$を作用させて生成します。
$$U_{in}\left(x_i\right)=\bigotimes_{j}{R_Z^{\left(j\right)}\left(cos^{-1}\left(x_i^2\right)\right)R_Y^{\left(j\right)}\left(sin^{-1}(x_i)\right)}\tag{69}$$
この問題において入力$x_i$は$1$次元なので全$6$量子ビットに対して同じ回転が作用されます。
測定するのは第$1$量子ビットの期待値$⟨Z⟩$であり、出力は$y=a⟨Z⟩$として値域を操作する$a$を係数に加えます。
この$a$はパラメータとして$\bm{\theta}$と一緒に最適化されます。
コスト関数は以下のような$2$乗誤差を使用します。
$$L\left(\bm{\theta}\right)={\sum_{\operatorname{i}}\left|\left|f\left(x_i\right)-y\left(x_i,\bm{\theta}\right)\right|\right|}^2\tag{70}$$
以上の条件で各関数の教師データ数を$100$として近似を行いました。
結果
図18に横軸を$x$、縦軸を$y$とした実験結果のグラフを示します。凡例の”initial”が初期値、”final”が最適化後の値、”teacher”が教師データです。
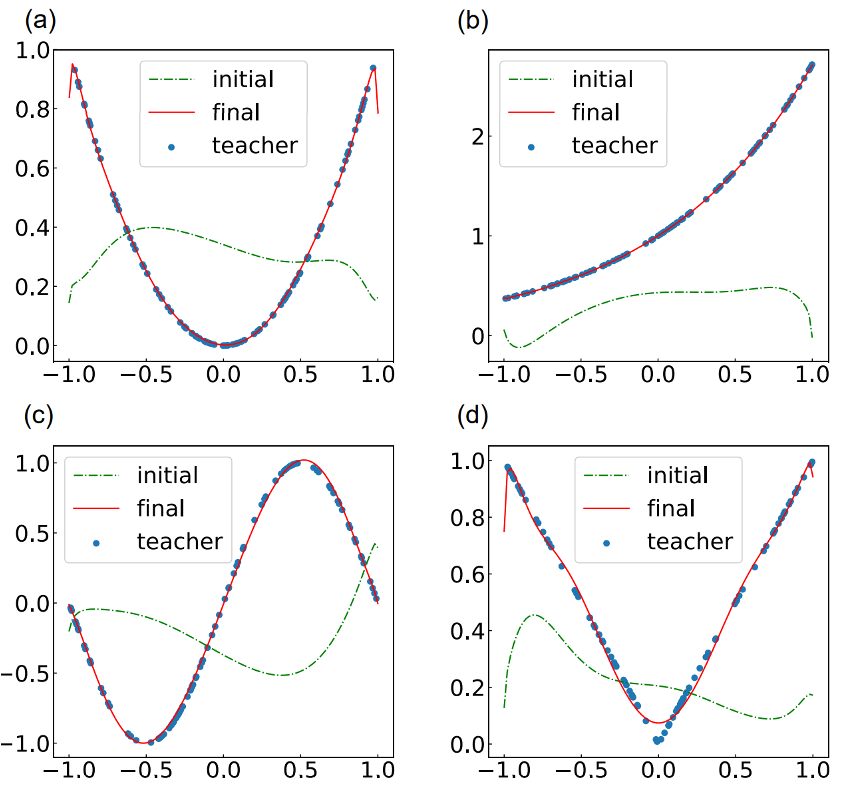
以上の結果から、全ての関数において良好に近似されていることがわかります。
マクローリン展開によって無限次数まで続く$\sin x$のような強い非線形関数や、$|x|$のような非解析的な関数の近似が成功していることから、非局所演算子($X\otimes X\otimes…\otimes X$のような演算子)の空間に隠れていた高次項を使用できていると考えられます。
$|x|$の$x=0$付近において近似が比較的悪いのはその非解析的性質($x=0$の点で微分不可)によるものであり、入力関数として別の関数系(ルジャンドル多項式など)を用いることで解決できると考えられます。
分類問題
問題定義
図19のようなデータセット(青:クラス$1$,赤:クラス$2$)に対して先述の量子回路を学習モデルとして分類問題を行います。
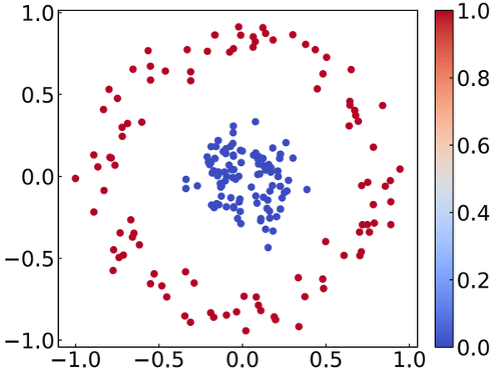
座標$\bm{x_i}=(x_{i,0},x_{i,1})$に対して出力$y=(クラス1の確率,クラス2の確率)$を最適化する問題として解きます。
まず、入力状態$\rho_{in}$は初期状態$\ket{0}$に対して以下の$U_{in}(x)$を作用させて生成します。
$$U_{in}\left(\bm{x}_\bm{i}\right)=\bigotimes_{j}{R_Z^{\left(j\right)}\left(cos^{-1}\left({x_{i,jmod2}}^2\right)\right)R_Y^{\left(j\right)}\left(sin^{-1}(x_{i,jmod2})\right)}\tag{71}$$
$j$は量子ビットの番号であり、偶数番号を座標の第$1$要素、奇数番号を第$2$要素として使用します。
全量子ビット数が$6$であるため、座標の各要素の数値はそれぞれ$3$量子ビットに対して埋め込まれます。
測定するのは第$1$、第$2$量子ビットの期待値$⟨Z_1⟩$,$⟨Z_2⟩$であり、出力$\bm{y_i}=(y_{i,1},y_{i,2})$は以下のソフトマックス関数を通したものを使用します。ここで$k$はクラスの番号であり、$k,j\in\{1,2\}$です。これにより$y_{i,1},y_{i,2}$の和は$1$になり確率として規格化されます。
$$y_{i,k}=\frac{e^{⟨Z_k⟩}}{\sum_{j\in\{1,2\}} e^{⟨Z_j⟩}}\tag{72}$$
コスト関数には以下のような確率分布が近いほど$0$に近づくクロスエントロピーを用います。
$$L=-\sum_i \sum_{k\in\{1,2\}}f_k(\mathbf{x}_i)\log y_{i,k}\tag{73}$$
教師データ$f(\bm{x_i})$はクラス$1$に対して$(1,0)$、クラス$2$に対して$(0,1)$として定義します。
以上の条件で教師データ数は各クラス$100$ずつとして分類問題を行いました。
結果
図20(a)は問題定義で示したデータセットで、色は正解ラベルを表します。図20(b)は学習後のモデルを $[-1,1]^2$ 上の格子点で評価し、式(72)で得られる所属確率を色で表したものです。図20(a)の色が正解ラベルの $0$ か $1$ であるのに対し、図20(b)の色は連続値の確率となります。
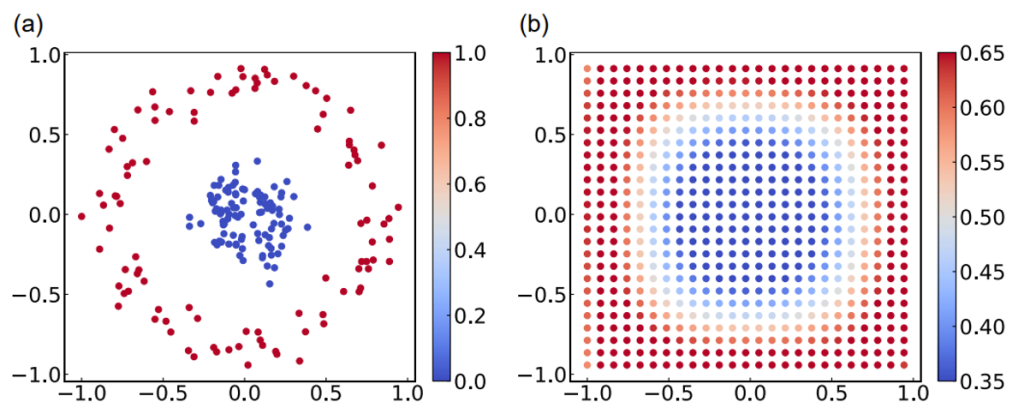
判定は確率 $0.5$ を境に行われるため、青い領域と赤い領域の境目にある $0.5$ の等高線がモデルの決定境界にあたります。青い領域は図20(a)で青い点が分布している範囲とおおむね一致し、赤い領域は赤い環の位置を含んでいるため、学習データを正しく分類できていることがわかります。
量子多体系ダイナミクスの近似
問題定義
横磁場イジングハミルトニアンの下で$10$スピン系の状態の時間による変化を先述の量子回路を学習モデルとして近似します。
まず、以下の横磁場イジングハミルトニアンの下で$10$スピン系の状態の時間による変化を事前にシミュレーションし、教師データを得ました。
$$H=\sum_{j=1}^{N}{a_jX_j}+\sum_{j=1}^{N}\sum_{k=1}^{j-1}J_{jk}Z_jZ_k\tag{74}$$
この式の$J_{jk},a_j$は回路内のハミルトニアンとは無関係に$[-1,1]$からランダムに選択します。
$10$スピン系は初期状態$\ket{0}^{\otimes10}$から開始し、初期の過渡的な時間区間($T_{transient}=300$)は破棄します。
そのため、学習対象は時間区間$t\in\left[T_{transient},T_{transient}+8\right]$における$3$つのスピンの$Z$の期待値とします。
入力状態を作るゲート、コスト関数、教師データ数などは非線形関数の近似のものと同じものを使用しますが、値域の調整の必要がないため、出力は第$1$、第$2$、第$3$量子ビットの期待値$⟨Z_1⟩,⟨Z_2⟩, ⟨Z_3⟩$をそのまま使います。
また、入力データは時間$t$とするのが自然ですが、$\sin ^{-1}(x)$などに入れるために定義域を以下の写像で$[-1,1]$に調整します。
$$t=4\left(x+1\right)+T_{transient}\tag{75}$$
以上の条件で量子多体系ダイナミクスの近似を行いました。
結果
図21に横軸を$[-1,1]$に写像した時間$t$、縦軸を量子ビットの期待値とした実験結果のグラフを示します。凡例の”initial”が初期値、”final”が最適化後の値、”teacher”が教師データです。
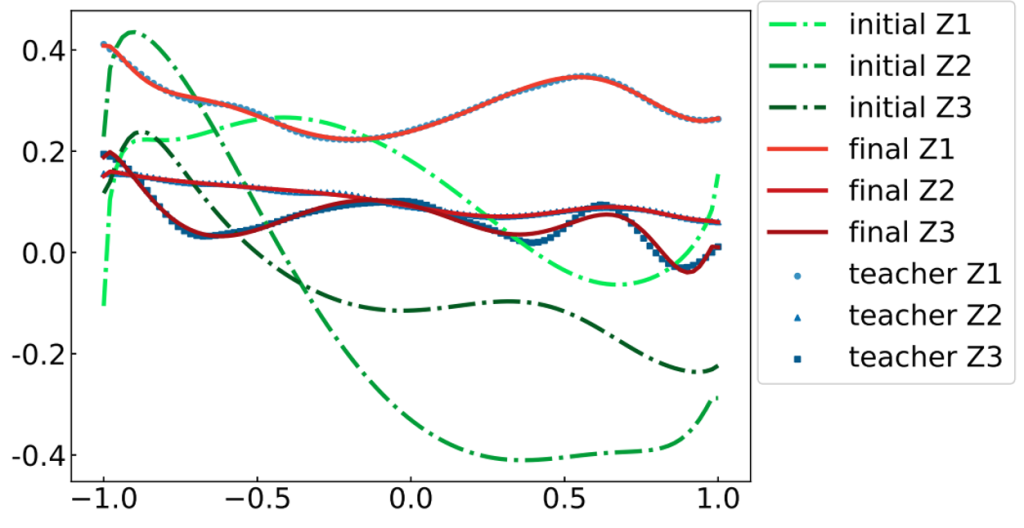
以上の結果から、全てのビットの$Z$の期待値において良好に近似されていることがわかります。
ここで注目すべきは、より複雑な $10$ スピン系の $3$ つの観測量が、$6$ 量子ビット回路の $3$ つの観測量によって同時に再現されている点です。ただし、ここで行っているのは通常の意味での量子シミュレーションではありません。対象系のハミルトニアンを量子回路上に再現しているのではなく、時間 $t$ を入力として観測量の値を返す関数を、教師データから近似しているだけです。その意味でこの結果は、近い将来の量子コンピュータで量子多体系のダイナミクスを扱うための、量子シミュレーションとは別の方法を提示しているものと位置づけられます。
また、出力を$x$に関して微分することで、システムのハミルトニアンの部分的な情報を抽出することも可能であり、これは勾配を計算するのと同じ方法で容易に実行できるといえます。
結論
本論文では新たな量子機械学習の枠組みとして、入力データを量子回路に与え、出力が教師信号に一致するように回路パラメータを調整する量子回路学習を提案しました。
数値シミュレーションの結果により、関数の表現、分類、比較的大きな量子システムの適合が可能であることが示されました。
あとがき
本論文の解説記事を書くにあたって、線形代数の知識があれば理解できる構成を意識して作成しました。
量子回路学習のアイデア自体は、パラメータを持ったモデルを用意して出力が教師信号に近づくようにパラメータを更新するという、古典的な機械学習と同じ構図であり、枠組みだけを追うのであれば難しいところはありません。しかし、なぜそれで非線形な関数が表現できるのか、なぜ勾配が期待値の測定だけで厳密に求まるのかを納得するには、量子状態を密度演算子とパウリ基底で表す見方が必要だったため、背景ではその点について重点的に扱いました。
整理していて特に面白いと感じたのは、入力データ$x_i$の$2$次以上の項が、符号化の段階ですでに状態の係数として現れているという点です。高次の項は回路が作り出すのではなく最初から状態の中にあり、それぞれの項の測定への寄与をパラメトリックゲートで操作するという構造がとても興味深かったです。
一方で、本論文の数値実験は最大で$N=6$量子ビットの古典シミュレーションであり、実機で同じ性能が得られるかは別の問題です。また、量子ビット数を増やすとコスト関数の勾配がほとんど$0$になり最適化が進まなくなる現象(バレンプラトー、barren plateau)など、この枠組みには近年指摘されている課題もあります。本論文はそうした議論の出発点にあたる提案であり、現在の量子ハードウェアで機械学習を行う際の設計の考え方を知るうえで、いま読んでも得るものの多い論文だと思います。
Appendix
テンソル積
テンソル積とは、$2$ つのベクトル空間の基底のあらゆる組み合わせを新しい基底とすることで、より大きなベクトル空間を作る構成のことです。$m$ 次元のベクトル空間 $V$ の基底を $\{\bm{e}_i\}$、$n$ 次元のベクトル空間 $W$ の基底を $\{\bm{f}_j\}$ とすると、その組み合わせ $\bm{e}_i\otimes\bm{f}_j$ は $mn$ 通りあります。これらを基底とする $mn$ 次元のベクトル空間を $V$ と $W$ のテンソル積空間と呼び、$V\otimes W$ と書きます。
合成系の状態空間がこの構成で与えられるのは、本文の多量子ビット系の節で述べたとおり、各量子ビットが取りうる状態のあらゆる組み合わせが独立な状態として許されるからです。$1$ 量子ビット目が $\ket{0},\ket{1}$ の $2$ 通り、$2$ 量子ビット目も $2$ 通りであれば、$2$ 量子ビット系では $4$ 通りが独立な基底になります。
ベクトル同士のテンソル積 $\bm{v}\otimes\bm{w}$ は、成分が $\left(\bm{v}\otimes\bm{w}\right)_{ij}=v_iw_j$ となるものとして定義されます。行列として書けば
$$\bm{v}\otimes\bm{w}\ \longleftrightarrow\ \begin{pmatrix}v_0w_0&v_0w_1\\v_1w_0&v_1w_1\end{pmatrix}=\begin{pmatrix}v_0\\v_1\end{pmatrix}\begin{pmatrix}w_0&w_1\end{pmatrix}\tag{76}$$
となり、列ベクトルと行ベクトルの積の形をしています。ただし $V\otimes W$ の元がすべて $\bm{v}\otimes\bm{w}$ の形に書けるわけではありません。テンソル積は基底を拡張しただけなのでその係数は制約を受けず、$V\otimes W$ の元は一般的に式(77)の形で書けます。
$$\bm{u}\ \longleftrightarrow\ \begin{pmatrix}u_{00}&u_{01}\\u_{10}&u_{11}\end{pmatrix}\tag{77}$$
式(76)の形で書ける元が本文でいう「各ビットが独立な状態」、書けない元がエンタングル状態です。
また、テンソル積の形でかける行列はランクが最大でも $1$ ですが、式(77)の一般の元はランク $2$ 以上にもなり得ます。
ランク $2$ 以上のとき、その系はエンタングル状態であるといえます。
$2\times2$ の場合、ランクが$2$で正則行列となるためこの判定は行列式が $0$ かどうかで行えます。実際に式(76)では$0$になることが確認できます。
演算子についても同じです。$V$ に作用する行列 $A$ と $W$ に作用する行列 $B$ から、$V\otimes W$ に作用する行列 $A\otimes B$ が
$$\left(A\otimes B\right)_{ij,kl}=a_{ik}b_{jl}\tag{78}$$
によって定まります。行列の成分が $2$ 添字だったので、$A\otimes B$の成分は $4$ 添字の配列になります。
ところが本文では、状態を $2^N$ 次元の列ベクトル、ゲートを $2^N\times2^N$ 行列として、状態のテンソルの添字を $1$ つにまとめた形で書いています。そうする理由は、$1$ 量子ビットのときと同じように行列の積、固有値、ユニタリ性などの線形代数における性質がそのまま使えるようにするためです。
$$\begin{pmatrix}u_{00}&u_{01}\\u_{10}&u_{11}\end{pmatrix}\ \longrightarrow\ \begin{pmatrix}u_{00}\\u_{01}\\u_{10}\\u_{11}\end{pmatrix}\tag{79}$$
量子論が状態空間に要求するのはヒルベルト空間であることだけなので、これは量子論において一般的に用いられる方法です。
本文では $C_{00},C_{01},C_{10},C_{11}$ のように$2$進数で見て昇順に並べています。
以上を踏まえて式(76)の操作を考えると式(80)のようになります。
$$\begin{pmatrix}v_0\\v_1\end{pmatrix}\otimes\begin{pmatrix}w_0\\w_1\end{pmatrix}=\begin{pmatrix}v_0\begin{pmatrix}w_0\\w_1\end{pmatrix}\\v_1\begin{pmatrix}w_0\\w_1\end{pmatrix}\end{pmatrix}=\begin{pmatrix}v_0w_0\\v_0w_1\\v_1w_0\\v_1w_1\end{pmatrix}\tag{80}$$
$\ket{0}=\begin{pmatrix}1\\0\end{pmatrix}$、$\ket{1}=\begin{pmatrix}0\\1\end{pmatrix}$ を代入すると
$$\ket{0}\otimes\ket{0}=\begin{pmatrix}1\\0\\0\\0\end{pmatrix},\hspace{5pt}\ket{0}\otimes\ket{1}=\begin{pmatrix}0\\1\\0\\0\end{pmatrix},\hspace{5pt}\ket{1}\otimes\ket{0}=\begin{pmatrix}0\\0\\1\\0\end{pmatrix},\hspace{5pt}\ket{1}\otimes\ket{1}=\begin{pmatrix}0\\0\\0\\1\end{pmatrix}\tag{81}$$
となり、互いに直交する $4$ つの基底ベクトルが得られます。本文ではこれらを $\ket{00},\ket{01},\ket{10},\ket{11}$ と略記しており、左側が $1$ 量子ビット目、右側が $2$ 量子ビット目に対応します。$N$ 量子ビット系ではこれを $N$ 個繰り返すことになり、本文の $\bigotimes_{j=1}^{N}$ はその繰り返しを表す記号です。
演算子についても同じ約束のもとで $4$ 添字が $2$ 添字にまとまり、式(78)は一方の行列の各成分にもう一方の行列を掛けたブロック行列として書けます。
$$A\otimes B=\begin{pmatrix}a_{00}&a_{01}\\a_{10}&a_{11}\end{pmatrix}\otimes B=\begin{pmatrix}a_{00}B&a_{01}B\\a_{10}B&a_{11}B\end{pmatrix}\tag{82}$$
たとえば $1$ 量子ビット目にのみ $X$ ゲートを作用させる操作は $X\otimes I$ と書け、
$$X\otimes I=\begin{pmatrix}0\cdot I&1\cdot I\\1\cdot I&0\cdot I\end{pmatrix}=\begin{pmatrix}0&0&1&0\\0&0&0&1\\1&0&0&0\\0&1&0&0\end{pmatrix}\tag{83}$$
となります。本文で $CNOT$ を入れ子のブロック行列として書いているのも、このテンソル積の構造を反映したものです。
なお、テンソル積は順序を入れ替えることができません。$A\otimes B$ と $B\otimes A$ は一般に異なる行列で、これは「どの量子ビットにどのゲートを作用させるか」が違うためです。本文で $X\otimes I\otimes I\otimes\cdots$ を $X_1$ と略記しているのは、この位置の情報を添字で表したものです。
$U(\theta)=e^{-i\theta H}$の導出
まずユニタリ性の条件から
$$U(\theta)U(\theta)^†=I\tag{84}$$
両辺を$\theta$で微分して
$$\frac{dU(\theta)}{d\theta}U(\theta)^†+U(\theta)\frac{dU(\theta)^†}{d\theta}=0\tag{85}$$
$$\frac{dU(\theta)}{d\theta}U(\theta)^†=-U(\theta)\frac{dU(\theta)^†}{d\theta}\tag{86}$$
右辺の共役転置を括り出して(転置なので行列の積の順序が逆になります)
$$\frac{dU(\theta)}{d\theta}U(\theta)^†=-(\frac{dU(\theta)}{d\theta}U(\theta)^†)^†\tag{87}$$
これは$\frac{dU(\theta)}{d\theta}U(\theta)^†$が反エルミート行列(共役転置をとると自分自身に$-1$を掛けた値になる行列)であることを意味します。
反エルミート行列はエルミート行列に$i$をかけることで表現できるため(共役をとって符号が反転するように)、$\theta$に依存しないエルミート行列$H$を使って
$$\frac{dU(\theta)}{d\theta}U(\theta)^†=-iH\tag{88}$$
と表せます。ここでマイナスをかけているのは最終的な形を上記の式に合わせるためですが、エルミート行列は実数をかけてもエルミート性を維持するため問題ありません。
両辺に$U(\theta)$を右からかけると、$U(\theta)^†U(\theta)=I$より
$$\frac{dU(\theta)}{d\theta}=-iHU(\theta)\tag{89}$$
この常微分方程式を初期条件$U(0)=I$の元で解くと
$$U(\theta)=e^{-i\theta H}\tag{90}$$
が導出されます。
本記事の作成者
澤田直樹